ลองนึกภาพผู้จัดการฝ่ายขายคัดลอกรายชื่อลูกค้า 200 รายจาก Excel ไปวางในแชตบอต แล้วขอให้ช่วยเขียนอีเมลติดตามงาน งานเสร็จในไม่กี่นาที แต่คำถามที่ตามมาจากฝ่ายกฎหมายคือ ข้อมูลชุดนั้นไปอยู่ที่ไหน ใครเห็นได้บ้าง ถูกเก็บนานเท่าไร และบริษัทแจ้งวัตถุประสงค์นี้กับลูกค้าไว้หรือเปล่า
คำถามแบบนี้ไม่ได้แปลว่า AI อันตราย แต่แปลว่าองค์กรยังไม่ได้ออกแบบว่าข้อมูลควรไหลอย่างไร บทความนี้แยกให้เห็นว่า Generative AI ระดับ frontier กับ AI Agent สำหรับองค์กรต่างกันตรงไหน ทำไมสองอย่างนี้ไม่ใช่ทางเลือกที่ต้องเลือกข้างเดียว และชั้นควบคุมแต่ละชั้นช่วยเรื่องความเป็นส่วนตัวกับความปลอดภัยอย่างไร
Generative AI ระดับ frontier คืออะไร
คำว่า frontier ในที่นี้หมายถึงโมเดลทั่วไปที่ความสามารถสูงที่สุดในแต่ละช่วงเวลา พัฒนาโดยห้องวิจัยอย่าง OpenAI, Anthropic และ Google คนส่วนใหญ่ใช้ผ่านแอปแชต เช่น ChatGPT, Claude หรือ Gemini ส่วนนักพัฒนาเรียกใช้ผ่าน API
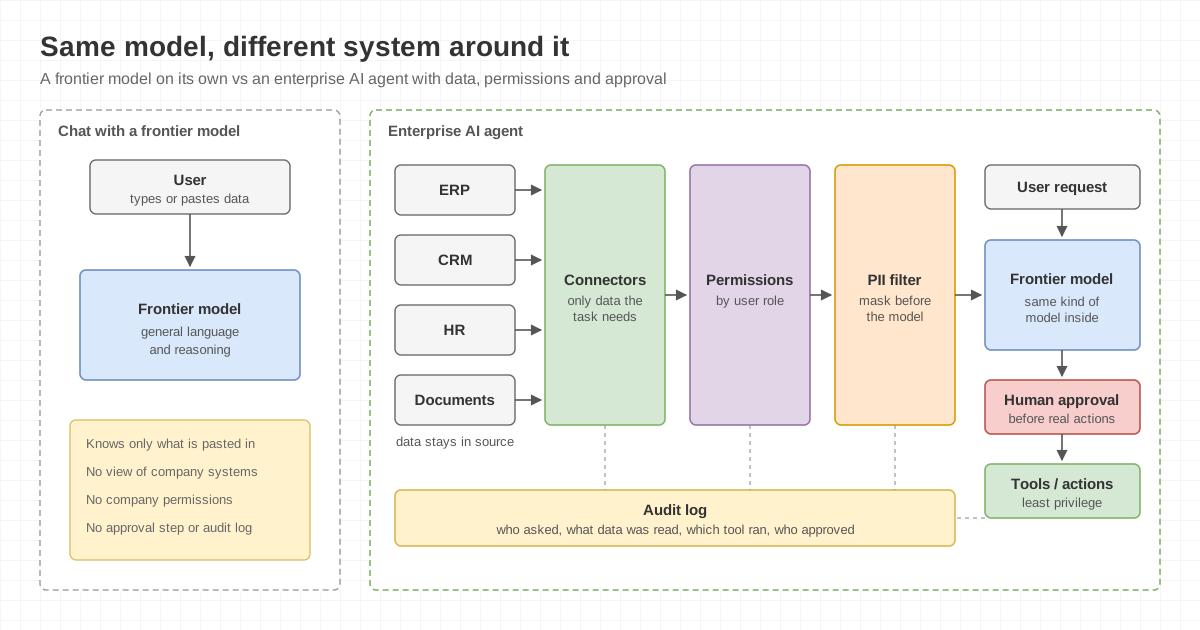
โมเดลกลุ่มนี้เก่งเรื่องภาษา สรุปความ เขียนร่าง แปล และให้เหตุผลกับโจทย์ที่ซับซ้อน แต่ตัวโมเดลเองไม่ทราบว่าลูกค้ารายไหนค้างชำระ ไม่ทราบว่าพนักงานคนนี้มีสิทธิ์ดูเงินเดือนใครบ้าง และไม่ทราบว่าใบสั่งซื้อเกิน 500,000 บาทต้องให้ใครอนุมัติ สิ่งที่มันรู้เกี่ยวกับบริษัทมีเท่าที่ผู้ใช้พิมพ์หรือแนบเข้าไปในบทสนทนานั้น
จุดนี้เองที่ทำให้เกิดพฤติกรรมคัดลอกข้อมูลไปวาง เพราะเป็นทางเดียวที่จะให้โมเดลช่วยงานกับข้อมูลจริงได้
AI Agent สำหรับองค์กรคืออะไร
AI Agent สำหรับองค์กรคือระบบที่สร้างไว้รอบโมเดล ในหลายกรณีข้างในก็ใช้โมเดลระดับ frontier นั่นเอง สิ่งที่เพิ่มเข้ามาคือชั้นที่ทำให้โมเดลทำงานกับข้อมูลและระบบของบริษัทได้ภายใต้กติกาของบริษัท
ชั้นที่พบบ่อยมีประมาณนี้
- การเชื่อมระบบ (connector หรือ API) ไปยัง ERP, CRM, HR, อีเมล และคลังเอกสาร
- การค้นคืนข้อมูล (retrieval) ที่ดึงเฉพาะส่วนที่เกี่ยวกับคำถาม และแนบแหล่งที่มาให้ผู้ใช้ตรวจได้
- เครื่องมือหรือ action ที่ agent เรียกได้ เช่น ค้นใบแจ้งหนี้ ร่างอีเมล หรือสร้างใบเสนอราคาฉบับร่าง
- สิทธิ์ตามบทบาท ที่ทำให้ agent เห็นข้อมูลไม่เกินสิทธิ์ของผู้ใช้ที่สั่งงาน
- ตัวกรองข้อมูลส่วนบุคคล ที่ตัดหรือปิดข้อมูลที่ไม่จำเป็นก่อนส่งให้โมเดล
- จุดอนุมัติโดยคน ก่อนการกระทำที่มีผลจริง
- บันทึกการทำงาน (audit log) ว่าใครสั่งอะไร agent อ่านข้อมูลอะไร และเรียกเครื่องมือใด
Anthropic อธิบายไว้ในบทความ Building effective agents ว่า workflow คือระบบที่ LLM กับเครื่องมือถูกจัดลำดับตามเส้นทางโค้ดที่กำหนดไว้ล่วงหน้า ส่วน agent คือระบบที่ LLM กำหนดขั้นตอนและการใช้เครื่องมือเองแบบไดนามิก ความต่างนี้สำคัญกับองค์กร เพราะยิ่งปล่อยให้ระบบตัดสินใจเองมาก ชั้นควบคุมรอบตัวยิ่งต้องแน่น งานหลายอย่างในบริษัทเหมาะกับ workflow ที่มีขั้นตอนตายตัวมากกว่า agent ที่คิดเส้นทางเอง
เทียบกันทีละประเด็น
| ประเด็น |
ใช้ Generative AI ผ่านแชตโดยตรง |
AI Agent สำหรับองค์กร |
| การเข้าถึงข้อมูล |
เท่าที่ผู้ใช้คัดลอกหรือแนบเข้าไป |
ดึงจากระบบต้นทางผ่าน connector เฉพาะส่วนที่งานต้องใช้ |
| สิทธิ์ |
ไม่เห็นสิทธิ์ของผู้ใช้ในระบบบริษัท |
ผูกกับสิทธิ์ตามบทบาทของผู้ใช้ที่สั่งงาน |
| การกระทำ |
ตอบเป็นข้อความ คนต้องไปทำต่อเอง |
เรียกเครื่องมือที่อนุญาตไว้ เช่น ค้นหา ร่าง หรือสร้างรายการ |
| ร่องรอยการตรวจสอบ |
ขึ้นกับแผนและการตั้งค่าของบริการ |
ออกแบบให้บันทึกคำสั่ง ข้อมูลที่อ่าน และเครื่องมือที่เรียก |
| ที่เก็บและระยะเวลาเก็บข้อมูล |
ขึ้นกับข้อตกลงของผู้ให้บริการและแผนที่ใช้ |
เลือกผู้ให้บริการ ข้อตกลง และส่วนที่เก็บในระบบบริษัทเองได้ |
| การอนุมัติโดยคน |
ไม่มีในตัว เพราะไม่มี action |
กำหนดได้ว่าขั้นไหนต้องหยุดรอคนอนุมัติ |
| ต้นทุนและความคาดเดาได้ |
เริ่มเร็ว ค่าใช้จ่ายต่อผู้ใช้ชัด แต่ควบคุมการใช้งานยาก |
มีค่าออกแบบและเชื่อมระบบ แต่จำกัดขอบเขตงานและวัดผลได้ |
| รูปแบบความผิดพลาด |
ตอบผิดหรือแต่งข้อมูล ข้อมูลรั่วจากการวางผิดที่ |
ตอบผิด บวกความเสี่ยงที่ agent ทำ action ผิด หรือถูกหลอกผ่านข้อมูลที่อ่าน |
แถวสุดท้ายสำคัญที่สุด agent ไม่ได้ปลอดภัยกว่าโดยอัตโนมัติ มันลดความเสี่ยงบางแบบ และเพิ่มความเสี่ยงบางแบบที่แชตไม่มี
ได้อะไรด้าน privacy และ security เมื่อออกแบบดี
ประโยชน์ด้านความเป็นส่วนตัวไม่ได้มาจากคำว่า agent แต่มาจากการควบคุมที่ใส่ไว้ในแต่ละชั้น
สิทธิ์น้อยที่สุดเท่าที่งานต้องใช้ เครื่องมือแต่ละตัวควรมีขอบเขตแคบ agent ที่ช่วยฝ่ายขายตอบคำถามสถานะคำสั่งซื้อไม่ควรมีเครื่องมือแก้ราคาสินค้า และไม่ควรใช้บัญชีระบบที่มีสิทธิ์ผู้ดูแล OWASP เรียกหลักนี้ว่า Least-Agency ใน Top 10 for Agentic Applications ฉบับ 2026 คือให้ agent มีอิสระเท่าที่งานต้องใช้ ไม่เกินนั้น
ข้อมูลอยู่ที่ระบบต้นทาง แทนที่จะคัดลอกฐานข้อมูลลูกค้าทั้งชุดไปเก็บในที่ใหม่ ระบบที่ดีจะอ่านจากต้นทางเมื่อจำเป็นและเก็บเพียงการอ้างอิง ข้อมูลจึงมีเจ้าของเดียว และเมื่อลบหรือแก้ที่ต้นทาง ก็ไม่มีสำเนาค้างอยู่อีกที่
ตัดข้อมูลส่วนบุคคลก่อนส่งให้โมเดล งานสรุปข้อร้องเรียนส่วนใหญ่ไม่ต้องใช้เลขบัตรประชาชนหรือเบอร์โทรของลูกค้า จึงปิดหรือแทนค่าก่อนส่งออกไปได้
เลือกข้อตกลงของผู้ให้บริการให้ตรงกับงาน ผู้ให้บริการรายใหญ่แยกเงื่อนไขของบริการธุรกิจหรือ API ออกจากบริการผู้บริโภค ตัวอย่างที่ตรวจจากหน้าทางการ ณ วันที่เขียน
- OpenAI ระบุในเอกสาร API ว่าตั้งแต่ 1 มีนาคม 2566 ข้อมูลที่ส่งผ่าน OpenAI API ไม่ถูกใช้ฝึกหรือปรับปรุงโมเดล เว้นแต่ลูกค้าเลือกแบ่งปันเอง และระบุด้วยว่ามี log สำหรับตรวจการใช้งานผิดนโยบายซึ่งอาจมี prompt และคำตอบ
- Anthropic ระบุว่าโดยค่าเริ่มต้นจะไม่ใช้ input และ output จากผลิตภัณฑ์เชิงพาณิชย์ เช่น Claude for Work และ Anthropic API ไปฝึกโมเดล ยกเว้นผู้ใช้ส่ง feedback หรือเลือกอนุญาตเอง
- Google ระบุในเงื่อนไข Gemini API ว่าบริการแบบเสียเงินจะไม่นำ prompt และคำตอบไปปรับปรุงผลิตภัณฑ์ ส่วนบริการที่ไม่เสียเงินอาจนำเนื้อหาไปใช้ปรับปรุงผลิตภัณฑ์ และมีผู้ตรวจที่เป็นคนอ่านได้ Google จึงเตือนไม่ให้ส่งข้อมูลอ่อนไหว ข้อมูลลับ หรือข้อมูลส่วนบุคคลเข้าบริการที่ไม่เสียเงิน
บัญชีส่วนตัวแบบฟรีกับบัญชีธุรกิจของผู้ให้บริการรายเดียวกันจึงอาจมีเงื่อนไขต่างกันมาก และเงื่อนไขเปลี่ยนได้ ฝ่ายจัดซื้อกับฝ่ายกฎหมายควรอ่านฉบับปัจจุบันก่อนเซ็นทุกครั้ง
บันทึกที่ตรวจย้อนได้ ถ้ามีคนถามว่าใครให้ AI อ่านสัญญาฉบับนี้ ระบบต้องตอบได้ว่าใคร เมื่อไร ผ่านเครื่องมือใด และผลลัพธ์ไปที่ไหน
คนอนุมัติก่อน action ที่มีผล การร่างอีเมลปล่อยให้ agent ทำได้ แต่การส่งอีเมลออกนอกบริษัท การแก้ข้อมูลลูกค้า หรือการสร้างรายการที่ผูกกับเงิน ควรหยุดรอคนกดยืนยัน และจุดหยุดนี้ต้องบังคับด้วยระบบ ไม่ใช่เขียนขอไว้ใน prompt
ป้องกัน prompt injection และการใช้เครื่องมือผิดทาง ข้อมูลที่ agent อ่าน เช่น อีเมลจากภายนอกหรือไฟล์แนบ อาจซ่อนคำสั่งไว้ ระบบจึงควรแยกข้อมูลออกจากคำสั่ง ตรวจค่าที่ส่งเข้าเครื่องมือ และไม่ให้ข้อความจากภายนอกเปลี่ยนสิทธิ์หรือเป้าหมายของงาน
ความเสี่ยงใหม่ที่ agent เพิ่มเข้ามา
OWASP Top 10 for LLM Applications ฉบับ 2025 มีหลายข้อที่ตรงกับเรื่องนี้ LLM01:2025 Prompt Injection คือกรณีที่ข้อความที่ป้อนเข้าไปเปลี่ยนพฤติกรรมหรือผลลัพธ์ของโมเดลแบบที่ไม่ได้ตั้งใจ LLM02:2025 Sensitive Information Disclosure คือการเปิดเผยข้อมูลอ่อนไหวผ่านคำตอบ และ LLM06:2025 Excessive Agency ซึ่ง OWASP แยกต้นเหตุไว้สามแบบ คือเครื่องมือมากเกินงาน (excessive functionality) สิทธิ์มากเกินงาน (excessive permissions) และปล่อยให้ทำเองมากเกินไป (excessive autonomy)
OWASP Top 10 for Agentic Applications for 2026 ซึ่งเผยแพร่เมื่อ 9 ธันวาคม 2568 ลงรายละเอียดฝั่ง agent มากขึ้น เช่น ASI01 Agent Goal Hijack ที่เป้าหมายของ agent ถูกเปลี่ยนผ่านเนื้อหาที่มันอ่าน ASI02 Tool Misuse and Exploitation ที่เครื่องมือซึ่งได้รับอนุญาตถูกใช้ในทางที่ไม่ได้ตั้งใจ ASI03 Identity and Privilege Abuse ที่เกี่ยวกับตัวตนและสิทธิ์ของ agent และ ASI09 Human-Agent Trust Exploitation ที่ใช้ความไว้ใจของคนต่อ agent เป็นช่องโหว่
ข้อสุดท้ายน่าคิดสำหรับผู้บริหาร จุดอนุมัติโดยคนช่วยได้ก็ต่อเมื่อคนอนุมัติได้เห็นข้อมูลพอจะตัดสินใจ ถ้าหน้าจออนุมัติแสดงเพียงว่า agent แนะนำให้กดยืนยัน คนก็จะกดตามความเคยชิน
มองผ่าน PDPA และแนวทางของไทย
พ.ร.บ.คุ้มครองข้อมูลส่วนบุคคล พ.ศ. 2562 ไม่ได้พูดถึง AI ตรง ๆ แต่หลักหลายมาตราใช้กับงานนี้โดยตรง
- มาตรา 21 ให้เก็บรวบรวม ใช้ หรือเปิดเผยข้อมูลตามวัตถุประสงค์ที่แจ้งไว้ การนำข้อมูลลูกค้าไปใช้กับ AI เพื่อวัตถุประสงค์ใหม่จึงต้องกลับไปดูว่าแจ้งไว้หรือมีฐานอื่นรองรับหรือไม่
- มาตรา 22 ให้เก็บรวบรวมได้เท่าที่จำเป็นภายใต้วัตถุประสงค์อันชอบด้วยกฎหมาย ซึ่งตรงกับแนวคิดตัดข้อมูลก่อนส่งให้โมเดล
- มาตรา 28 วางหลักการส่งหรือโอนข้อมูลไปต่างประเทศ ว่าประเทศปลายทางต้องมีมาตรฐานคุ้มครองที่เพียงพอตามหลักเกณฑ์ที่คณะกรรมการประกาศ เว้นแต่เข้าข้อยกเว้น เมื่อโมเดลประมวลผลบนเซิร์ฟเวอร์นอกประเทศ คำถามนี้จึงต้องมีคำตอบ
- มาตรา 37 (1) ให้ผู้ควบคุมข้อมูลจัดมาตรการรักษาความมั่นคงปลอดภัยที่เหมาะสม และทบทวนเมื่อเทคโนโลยีเปลี่ยน ส่วนมาตรา 37 (2) ให้ป้องกันไม่ให้ผู้ที่ได้รับข้อมูลไปใช้หรือเปิดเผยโดยมิชอบ
- มาตรา 40 กำหนดหน้าที่ของผู้ประมวลผลข้อมูล เช่น ทำตามคำสั่งของผู้ควบคุมข้อมูลเท่านั้น และจัดมาตรการรักษาความปลอดภัย ข้อนี้เกี่ยวกับการทำสัญญากับผู้ให้บริการ AI
ด้านธรรมาภิบาล AI ของไทย ศูนย์ AIGC ของ ETDA เผยแพร่ Thailand's AI Governance Guideline for Executive ที่แบ่งงานเป็นสามเสา คือโครงสร้างการกำกับดูแล AI กลยุทธ์ AI และการดำเนินงาน AI และมี Security & Privacy เป็นหนึ่งในหลักจริยธรรม AI ส่วนกรอบสากล NIST เผยแพร่ AI Risk Management Framework เมื่อ 26 มกราคม 2566 เป็นกรอบสมัครใจ และเผยแพร่ Generative AI Profile (NIST AI 600-1) เมื่อ 26 กรกฎาคม 2567 เป็นเอกสารคู่กันสำหรับความเสี่ยงของ Generative AI
ใช้แบบไหนเมื่อไร
- งานเขียน สรุป แปล หรือระดมความคิด ที่ไม่มีข้อมูลลูกค้า พนักงาน หรือความลับทางการค้า ใช้แชต AI แบบบัญชีธุรกิจได้ โดยมีนโยบายการใช้งานกำกับ
- งานที่ต้องตอบจากเอกสารภายใน เช่น นโยบาย คู่มือ หรือสัญญา ควรใช้ระบบค้นคืนข้อมูลที่ตรวจสิทธิ์และแสดงแหล่งที่มา แทนการอัปโหลดไฟล์เข้าแชตทีละครั้ง
- งานที่ต้องอ่านข้อมูลจาก ERP, CRM หรือ HR ควรผ่าน connector ที่จำกัดขอบเขตและผูกสิทธิ์ตามบทบาท
- งานที่เปลี่ยนข้อมูล ส่งอีเมลออกนอกบริษัท หรือเกี่ยวกับเงิน ใช้ agent ได้ แต่ต้องมีจุดอนุมัติโดยคนและบันทึกการทำงาน
- ถ้างานมีขั้นตอนตายตัวอยู่แล้ว ให้เริ่มจาก workflow ที่กำหนดเส้นทางไว้ก่อน แล้วค่อยเพิ่มอิสระให้ agent เมื่อวัดผลแล้วว่าคุ้ม
คำถามก่อนเชื่อม AI กับข้อมูลบริษัท
- งานนี้ต้องใช้ข้อมูลส่วนบุคคลจริงหรือไม่ ถ้าใช้ ใช้ฟิลด์ไหนบ้าง
- วัตถุประสงค์นี้อยู่ในสิ่งที่แจ้งเจ้าของข้อมูลไว้หรือมีฐานทางกฎหมายรองรับหรือไม่
- ผู้ให้บริการโมเดลประมวลผลที่ไหน เก็บข้อมูลนานเท่าไร และข้อตกลงเรื่องการนำไปฝึกโมเดลเขียนไว้อย่างไร
- agent ใช้บัญชีของใครในการเข้าระบบ และสิทธิ์ของบัญชีนั้นกว้างกว่างานหรือไม่
- เครื่องมือใดบ้างที่ agent เรียกได้ และตัวไหนต้องหยุดรอคนอนุมัติ
- เมื่อ agent อ่านเนื้อหาจากภายนอก ระบบกันไม่ให้ข้อความนั้นกลายเป็นคำสั่งอย่างไร
- ถ้าเกิดเหตุ บันทึกการทำงานพอให้ไล่ย้อนได้หรือไม่ และใครเป็นคนดู
- ผลลัพธ์ที่ผิดจะถูกจับได้ที่ขั้นไหน ก่อนไปถึงลูกค้าหรือไม่
บทความ ส่วนประกอบของ AI Agent ที่ใช้งานจริง ลงรายละเอียดฝั่งสถาปัตยกรรม ส่วน จุดอนุมัติเมื่อ AI ทำงานผ่านเบราว์เซอร์ อธิบายการแยกขอบเขตการกระทำ และ ฐานข้อมูลและโครงสร้างพื้นฐานสำหรับ AI เหมาะกับทีมที่ยังไม่แน่ใจว่าข้อมูลพร้อมแค่ไหน
คำถามที่พบบ่อย
AI Agent คืออะไร ต่างจากแชตบอตอย่างไร
แชตบอตตอบเป็นข้อความจากสิ่งที่ผู้ใช้ป้อน ส่วน AI Agent เรียกเครื่องมือ อ่านข้อมูลจากระบบ และทำงานหลายขั้นตอนจนงานเสร็จ ฉบับองค์กรจะมีสิทธิ์ตามบทบาท จุดอนุมัติ และบันทึกการทำงานเพิ่มเข้ามา
Generative AI กับ AI Agent ต่างกันอย่างไร ต้องเลือกอย่างใดอย่างหนึ่งไหม
ไม่ต้องเลือก Generative AI คือโมเดลที่สร้างเนื้อหา ส่วน AI Agent คือระบบที่ใช้โมเดลนั้นเป็นแกน แล้วเพิ่มการเชื่อมข้อมูล เครื่องมือ และการควบคุม
ใช้ ChatGPT ในองค์กรปลอดภัยไหม
ขึ้นกับแผนที่ใช้ การตั้งค่า และข้อมูลที่ใส่ลงไป บริการแบบธุรกิจหรือ API ของผู้ให้บริการรายใหญ่มักมีเงื่อนไขเรื่องการนำข้อมูลไปฝึกโมเดลต่างจากบัญชีส่วนตัว องค์กรควรกำหนดว่าข้อมูลประเภทใดห้ามใส่ ใช้บัญชีที่บริษัทควบคุมได้ และอ่านข้อตกลงฉบับปัจจุบันของผู้ให้บริการ
ใช้ ChatGPT กับข้อมูลลูกค้าผิด PDPA ไหม
ไม่มีคำตอบเดียว ต้องดูว่าวัตถุประสงค์ตรงกับที่แจ้งลูกค้าไว้หรือมีฐานทางกฎหมายรองรับหรือไม่ ใช้ข้อมูลเกินจำเป็นหรือเปล่า ข้อมูลถูกส่งไปต่างประเทศภายใต้เงื่อนไขใด และมีสัญญากับผู้ให้บริการที่กำหนดหน้าที่ด้านความปลอดภัยหรือไม่ บทความนี้ไม่ใช่คำแนะนำทางกฎหมาย กรณีจริงควรปรึกษาที่ปรึกษากฎหมายหรือเจ้าหน้าที่คุ้มครองข้อมูลส่วนบุคคลขององค์กร
AI กับ PDPA ควรเริ่มจัดการจากตรงไหน
เริ่มจากทำรายการว่างาน AI แต่ละงานใช้ข้อมูลส่วนบุคคลชุดไหน เพื่ออะไร ส่งไปที่ใด และใครเข้าถึงได้ จากนั้นตัดข้อมูลที่ไม่จำเป็นออก ผูกสิทธิ์ตามบทบาท และเก็บบันทึกให้ตรวจย้อนได้ งานเหล่านี้คือการใช้หลัก PDPA เดิมกับเครื่องมือใหม่
งานที่ Enersys ทำ
Enersys เป็นซอฟต์แวร์เฮาส์ในกรุงเทพฯ ที่ทำงานซอฟต์แวร์ธุรกิจมาตั้งแต่ปี 2555 งาน AI ของเราเริ่มจากช่วยเลือกงานที่เหมาะกับ AI และตกลงวิธีวัดผล เตรียมและเชื่อมข้อมูลที่งานนั้นต้องใช้ แล้ววาง AI Agent เข้าไปในขั้นตอนงาน โดยกำหนดว่าขั้นไหนต้องมีคนตรวจหรืออนุมัติ และให้สิทธิ์เป็นไปตามบทบาทของผู้ใช้ ดูภาพรวมได้ที่ หน้า AI
Genesis AI เชื่อมกับ ERP, CRM, HR, อีเมล และคลังเอกสาร ผ่าน API หรือ connector ที่ระบบรองรับ และตอบคำถามจากเอกสารพร้อมแหล่งที่มาให้ผู้ใช้ตรวจต้นฉบับ ส่วน PrivacyHub ใช้กำกับงานด้าน PDPA โดยข้อมูลส่วนบุคคลยังอยู่ในระบบต้นทาง และ PrivacyHub เก็บเฉพาะ metadata
ถ้ายังไม่แน่ใจว่าองค์กรพร้อมแค่ไหน ลองทำ แบบประเมินความพร้อมด้าน AI หรือ คุยกับทีมเรา เรื่องงานที่อยากเริ่ม
แหล่งข้อมูล
เข้าถึงทุกลิงก์เมื่อ 14 ต.ค. 2569