หากทีมต้องอ่านใบเสนอราคาที่เป็นภาพ แล้วจับคู่กับเสียงอธิบายจากพนักงาน Gemma 4 รุ่นที่ควรเริ่มทดสอบอาจเป็น 12B Unified เพราะรับข้อมูลสองแบบนี้ได้ในโมเดลเดียว แต่การเลือกรุ่นยังต้องดูว่าโปรแกรมที่ใช้เปิดรับเสียงหรือไม่ และเครื่องเหลือหน่วยความจำให้เอกสารกับผู้ใช้พร้อมกันเท่าไร
คู่มือนี้ปรับปรุงเมื่อ 19 ตุลาคม 2569 โดยคงวันเผยแพร่เดิมไว้ Google เพิ่ม Gemma 4 12B Unified เมื่อ 3 มิถุนายน 2569 หลังรุ่นแรก E2B, E4B, 26B A4B และ 31B ที่ระบุใน release notes วันที่ 31 มีนาคม 2569 จึงต้องประเมินทางเลือกใหม่จาก 5 รุ่น ไม่ใช่อาศัยตารางช่วงเปิดตัวอย่างเดียว ดูประวัติรุ่นจาก Google
เนื้อหาต่อไปนี้เป็นแนวทางทดลองและออกแบบระบบ ตัวอย่างองค์กรเป็นสถานการณ์สมมติ ไม่ใช่ผลโครงการหรือผลวัดประสิทธิภาพของ Enersys คำสั่งตรวจเทียบกับเอกสารผู้พัฒนาแล้ว แต่ไม่ได้หมายความว่าเราได้รันโมเดลทุกชุดบนฮาร์ดแวร์ทุกรุ่น
เลือก Gemma 4 รุ่นใดก่อน
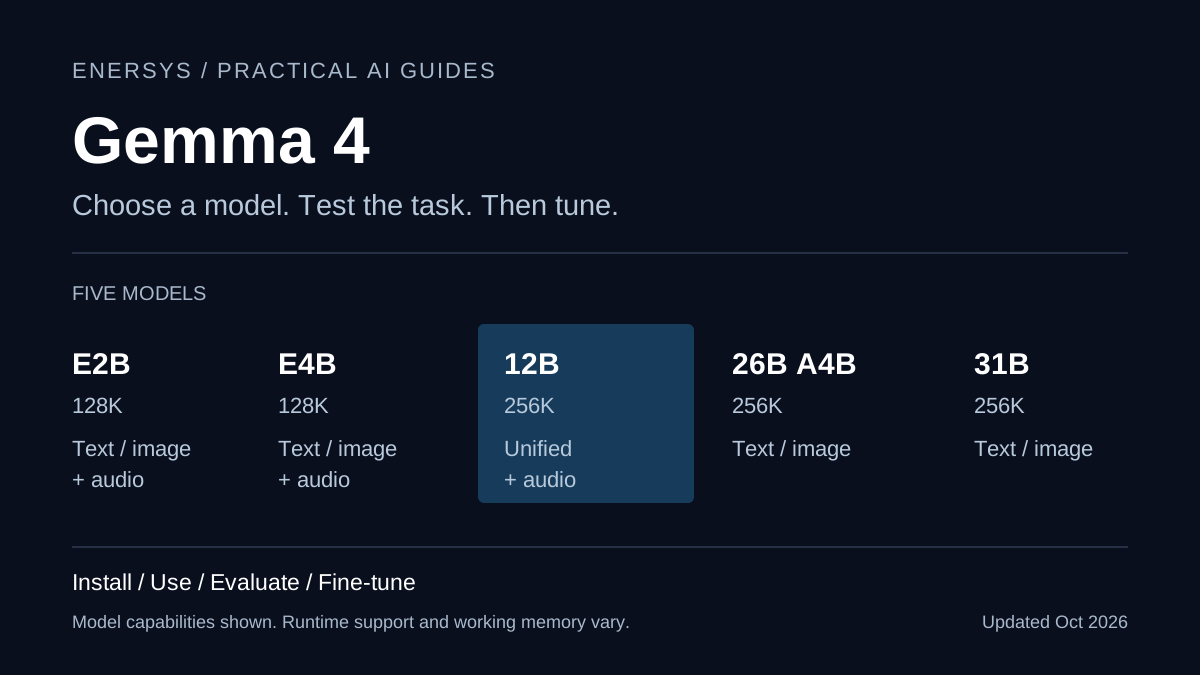
Gemma 4 เป็นตระกูลโมเดลแบบ open weights ของ Google DeepMind รับข้อมูลหลายรูปแบบและตอบกลับเป็นข้อความ ตารางนี้แสดงความสามารถของตัวโมเดล ส่วนความสามารถที่ใช้งานได้จริงขึ้นกับ runtime และรูปแบบไฟล์ด้วย
| รุ่น |
รูปแบบและขนาดตาม model card |
Context สูงสุด |
ข้อมูลเข้า |
| E2B |
2.3B effective, รวม embedding 5.1B |
128K tokens |
ข้อความ ภาพ เสียง |
| E4B |
4.5B effective, รวม embedding 8B |
128K tokens |
ข้อความ ภาพ เสียง |
| 12B Unified |
Dense 11.95B |
256K tokens |
ข้อความ ภาพ เสียง |
| 26B A4B |
MoE รวม 25.2B, ใช้งาน 3.8B ต่อ token |
256K tokens |
ข้อความ ภาพ |
| 31B |
Dense 30.7B |
256K tokens |
ข้อความ ภาพ |
ที่มา Google Gemma 4 model card ปรับปรุง 30 กรกฎาคม 2569 คำว่า effective ในรุ่น E และ active ในรุ่น MoE ไม่ใช่จำนวนพารามิเตอร์ทั้งหมดที่ต้องเก็บในหน่วยความจำ
ถ้าเครื่องมีทรัพยากรจำกัด เริ่มจาก E2B หรือ E4B เพื่อดูว่างานง่ายผ่านเกณฑ์หรือยัง ถ้างานต้องรวมภาพกับเสียงและมีเครื่องระดับแล็ปท็อป GPU หรือ workstation ให้ทดสอบ 12B คู่กับ E4B ด้วยชุดงานเดียวกัน ส่วน 26B A4B เหมาะเป็นคู่เปรียบเทียบเมื่องานเน้นข้อความกับภาพและยอมรับหน่วยความจำที่สูงขึ้นได้ 31B ควรเข้ารอบเมื่อคุณภาพที่เพิ่มขึ้นคุ้มเวลาและทรัพยากรที่วัดได้
อย่าเลือกจากคะแนนรวมเพียงตัวเดียว งานอ่านเลขที่เอกสารภาษาไทย งานสรุปข้อยกเว้นในสัญญา และงานถอดเสียงในโรงงานมีจุดพลาดคนละแบบ รุ่นที่ได้อันดับดีกว่าอาจยังอ่านเลขภาษีผิดเหมือนกัน
12B Unified เปลี่ยนอะไร
12B ใช้โครงสร้าง encoder-free โดยส่งข้อมูลภาพและเสียงผ่านชั้นฉายข้อมูลขนาดเล็กเข้าสู่ transformer แกนเดียว แทนการใช้ encoder แยกแบบรุ่นอื่น Google ระบุว่ารองรับการปรับด้วย LoRA หรือปรับน้ำหนักทั้งโมเดลได้ และยกเครื่องที่มี VRAM หรือ unified memory 16 GB เป็นตัวอย่างการรันในเครื่อง อ่านรายละเอียดสถาปัตยกรรมและการเริ่มใช้งาน
ตัวเลข 16 GB เป็นจุดอ้างอิงของผู้พัฒนา ไม่ใช่คำรับรองว่าเปิด context 256K หรือรับหลายคำขอพร้อมกันได้บนทุกเครื่อง การรัน inference กับการฝึกเป็นคนละภาระหน่วยความจำ
ตรวจเครื่องและงบก่อนดาวน์โหลด
แยกพื้นที่เก็บไฟล์โมเดลออกจาก RAM หรือ VRAM ที่ใช้ขณะรัน หลังโหลด weights ยังมี KV cache สำหรับประวัติสนทนา ข้อมูลภาพหรือเสียง พื้นที่ทำงานของ runtime และโปรแกรมอื่นในเครื่อง ยิ่งเปิด context ยาวหรือเพิ่มจำนวนผู้ใช้พร้อมกัน ยิ่งต้องวัดการใช้หน่วยความจำใหม่
ก่อนทดลอง บันทึก GPU และ VRAM, RAM หรือ unified memory, ระบบปฏิบัติการ, runtime และเวอร์ชัน, ชื่อโมเดลกับ quantization แล้วเริ่มด้วยเอกสารสั้นและผู้ใช้คนเดียว หากติดตั้ง PyTorch ให้เลือกชุดที่ตรงกับ CUDA และ driver ของเครื่องจาก หน้าติดตั้ง PyTorch ไม่ควรเดาจากชื่อ GPU อย่างเดียว
สำหรับงบ ให้คิดค่าเครื่องหรือ GPU รายชั่วโมง ค่าไฟ พื้นที่เก็บข้อมูล การสำรองข้อมูล และเวลาคนดูแลรวมกัน การดาวน์โหลด weights ได้โดยไม่เสียค่าตัวโมเดลไม่ได้ทำให้การให้บริการไม่มีต้นทุน ถ้าใช้บริการ hosted ให้ตรวจราคาของรุ่นและผู้ให้บริการในวันใช้งาน แทนการล็อกตัวเลขราคาและ rate limit ไว้ในคู่มือ
เริ่มใช้งานในเครื่องด้วย Ollama
เส้นทางนี้เหมาะกับการลองข้อความและภาพ ติดตั้งหรืออัปเดต Ollama จาก เว็บไซต์ผู้พัฒนา แล้วตรวจเวอร์ชันก่อนเลือกชื่อรุ่นอย่างชัดเจน คำสั่งต่อไปนี้ใช้ terminal บนเครื่องที่ติดตั้ง Ollama แล้ว
ollama --version
ollama pull gemma4:12b
ollama run gemma4:12b
หากเครื่องไม่พอ ให้เปลี่ยนชื่อรุ่นเป็น gemma4:e4b หรือ gemma4:e2b สำหรับการเปรียบเทียบครั้งถัดไป Ollama แสดง 12B download ประมาณ 7.7 ถึง 8.0 GB ในรายการที่ตรวจวันที่ปรับปรุงบทความ ขนาดนี้ไม่ใช่ working RAM ตรวจ tag ขนาดไฟล์ และความสามารถปัจจุบัน
อย่าถือว่า gemma4 โดยไม่ระบุ tag หมายถึง 12B รายการปัจจุบันผูก latest กับ E4B และแสดงรุ่น local เหล่านี้เป็น Text, Image คู่มือนี้จึงไม่ใช้ Ollama เป็นตัวอย่างส่งเสียง แม้ตัว weights บางรุ่นรองรับเสียงก็ตาม
เรียกผ่าน local API
เมื่อ Ollama ทำงานอยู่แล้ว ให้ลองจาก terminal อีกหน้าต่าง หากใช้แบบ CLI โดยไม่มีแอปหรือ service ให้เริ่ม ollama serve ก่อน หากมี service อยู่แล้วไม่ต้องเปิดซ้ำ
curl http://localhost:11434/api/chat \
  -H 'Content-Type: application/json' \
  -d '{
    "model": "gemma4:12b",
    "stream": false,
    "messages": [
      {"role": "system", "content": "Use only the supplied document. Say when a value is missing."},
      {"role": "user", "content": "Document: quotation Q-001, total THB 12500. Extract the quotation ID and total."}
    ]
  }'
เลข Q-001 และ 12,500 บาทเป็นข้อมูลสมมติ ลองลบยอดออกจาก prompt แล้วดูว่าโมเดลยอมแจ้งว่าไม่พบหรือแต่งตัวเลขขึ้นมา เก็บคำตอบจริงไว้เทียบกับคำตอบที่ผู้ตรวจรับรอง ไม่ควรถือว่าการตอบได้ครั้งแรกคือผ่านการทดสอบแล้ว เอกสาร chat API ของ Ollama
API ที่เปิดใช้ในเครื่องยังต้องมีการควบคุมสิทธิ์เมื่อเชื่อมกับระบบองค์กร อย่าเปิด port ของตัวอย่างนี้ออกสู่อินเทอร์เน็ตโดยตรง
ใช้ Python ผ่าน Hugging Face Transformers
เส้นทางนี้เหมาะกับทีมที่ต้องควบคุมข้อมูลเข้า ประเมินผลซ้ำ หรือพัฒนาต่อใน Python สร้าง environment แยกก่อน บน Windows ให้ใช้คำสั่ง activate ที่ตรงกับ shell ของตน
python3 -m venv .venv
source .venv/bin/activate
python -m pip install torch accelerate "transformers>=5.10.1"
Google text quickstart ปัจจุบันระบุ Transformers ตั้งแต่ 5.10.1 ขึ้นไปสำหรับตัวอย่าง Gemma 4 เลือก PyTorch build ให้ตรงเครื่องตามหัวข้อก่อนหน้า แล้วบันทึกเวอร์ชันที่ทดสอบผ่านไว้ การใช้ dtype="auto" ไม่ได้ทำ quantization เป็น 4-bit ให้อัตโนมัติ ดังนั้นไฟล์และหน่วยความจำของเส้นทางนี้ต่างจาก Ollama
บันทึกเป็น try_gemma.py ตัวอย่างนี้ใช้รูปแบบ messages ตาม quickstart และเลือก 12B แบบ instruction-tuned (it)
from transformers import GenerationConfig, pipeline

model_id = "google/gemma-4-12B-it"
pipe = pipeline(
    task="text-generation",
    model=model_id,
    device_map="auto",
    dtype="auto",
)
config = GenerationConfig.from_pretrained(model_id)
config.max_new_tokens = 256
messages = [
    {
        "role": "user",
        "content": [{"type": "text", "text": "Explain the difference between an invoice and a quotation."}],
    }
]
result = pipe(messages, return_full_text=False, generation_config=config)
print(result[0]["generated_text"])
python try_gemma.py
python -m pip freeze > requirements-tested.txt
หากหน่วยความจำไม่พอ ให้เริ่มจาก google/gemma-4-E2B-it เพื่อทดสอบ environment ก่อน การเปลี่ยนรุ่นเป็นเพียงขั้นตรวจระบบ ไม่ใช่การยืนยันว่าคุณภาพเท่ากับ 12B หาก repository ขอสิทธิ์เข้าถึง ให้ทำตามหน้าของโมเดลและจัดเก็บ token ผ่านกลไก secrets ของเครื่อง ไม่ใส่ token ลงในสคริปต์หรือ Git Google text quickstart และ notebook ต้นฉบับ
ส่งภาพ เสียง และใช้ thinking ให้ถูกเส้นทาง
เริ่มทดสอบภาพด้วยเอกสารที่มีเฉลย เช่น ภาพใบเสนอราคาจำลองที่ตัวเลขชัดเจน แล้วเพิ่มภาพเอียง ตัวอักษรเล็ก และตารางหลายหน้า แยกคะแนนอ่านตัวอักษรออกจากคะแนนตีความข้อมูล ขอให้โมเดลบอกช่องที่อ่านไม่ออกแทนการเติมค่าเอง และตรวจ JSON หรือชนิดข้อมูลในแอปอีกชั้น
สำหรับเสียง ให้ใช้ notebook หรือ runtime ที่ระบุรองรับเสียงของรุ่นนั้นโดยตรง เช่น คู่มือ audio understanding ของ Google ซึ่งมีตัวอย่าง processor และการจัดเตรียมเสียง อย่าส่งไฟล์เสียงเข้า endpoint ที่รองรับเฉพาะข้อความและคาดว่าจะทำงานได้
Google model card ระบุเพดานเสียง 30 วินาที และวิดีโอ 60 วินาทีที่ 1 frame ต่อวินาทีสำหรับแนวทางที่อธิบายในหน้านั้น ขณะที่ตัวอย่างสาธิต 12B บางชุดใช้การเตรียมข้อมูลที่ยาวกว่า จึงควรเริ่มทดสอบด้วยเสียงสั้นไม่เกิน 30 วินาที แล้วตรวจข้อจำกัดของรุ่นและ runtime ที่เลือกก่อนขยาย อย่าสัญญาว่าไฟล์ประชุมยาวทั้งชั่วโมงจะทำงานได้เพียงเพราะ context window ใหญ่
Thinking เป็นอีกตัวแปรที่ต้องเทียบคุณภาพกับเวลารอ ใช้ chat template และตัวเลือกของ runtime รุ่นปัจจุบัน แทนการนำ control tokens ของ Gemma รุ่นก่อนมาใส่เอง เมื่อเก็บประวัติหลายรอบให้เก็บคำตอบสุดท้ายตามข้อแนะนำของผู้พัฒนา การแสดงข้อความ reasoning ไม่ใช่หลักฐานว่าคำตอบถูกต้อง รูปแบบ prompt ของ Gemma 4
ถ้าจะใช้ function calling ให้แอปตรวจชื่อเครื่องมือ schema และสิทธิ์ก่อนทำงานเสมอ โมเดลที่เสนอคำสั่งแก้ยอด ERP ไม่ได้มีอำนาจอนุมัติรายการนั้น ควรเริ่มจากเครื่องมืออ่านข้อมูล และให้คนอนุมัติการเปลี่ยนแปลงที่มีผลต่อธุรกิจ คู่มือ function calling
ทดลอง 12B ด้วย LiteRT-LM
Google เผยแพร่ตัวอย่าง import 12B และเปิด local API ที่เข้ากันได้กับรูปแบบ OpenAI ใช้ CLI รุ่นที่รองรับคำสั่งนี้ และติดตั้ง uv ก่อนหากยังไม่มี
uv tool install litert-lm
litert-lm --help
litert-lm import --from-huggingface-repo=litert-community/gemma-4-12B-it-litert-lm gemma-4-12B-it.litertlm gemma4-12b
litert-lm serve
ตรวจ address, port และชื่อโมเดลจากข้อความที่ CLI แสดงกับเอกสารของเวอร์ชันที่ติดตั้ง ก่อนต่อ client จริง อย่านำ port ของ Ollama มาใช้แทนโดยอัตโนมัติ คำว่า OpenAI-compatible อธิบายรูปแบบ API ไม่ได้หมายความว่าข้อมูลต้องส่งไป OpenAI คำสั่งจาก Google 12B developer guide
ถ้าจะทำแอป Android หรือ iOS ให้เริ่มจาก bundle และ API ที่ Google AI Edge ระบุรองรับบนอุปกรณ์นั้น การรันใน desktop CLI ได้ยังไม่ยืนยันว่ามือถือมี RAM หรือ backend รองรับครบ ตรวจ LiteRT-LM platform guides และทดสอบบนเครื่องจริงก่อนวางแผนใช้งานแบบ offline
ควรใช้ RAG หรือ Fine-Tuning
ถ้าคำตอบต้องอิงราคาล่าสุด นโยบายฉบับปัจจุบัน หรือสิทธิ์ของผู้ใช้ ให้เริ่มจากการดึงเอกสารที่อนุญาตให้เห็นมาเป็นบริบท (RAG) พร้อมแสดงแหล่งอ้างอิง การฝึกให้จำข้อมูลที่เปลี่ยนทุกวันทำให้แก้ข้อมูลและตรวจสิทธิ์ยากขึ้น
Fine-Tuning เหมาะเมื่อชุดทดสอบชี้ว่าปัญหาเกิดซ้ำในพฤติกรรม เช่น เขียนผลลัพธ์ผิดรูปแบบ แยกประเภทงานตามนิยามขององค์กรไม่ได้ หรือใช้คำเฉพาะไม่สม่ำเสมอ LoRA ฝึก adapter ขนาดเล็กเพิ่มบนโมเดลเดิม ส่วน QLoRA ใช้ weights ฐานแบบ quantized ระหว่างฝึกเพื่อลดภาระหน่วยความจำ การฝึกไม่ได้รับประกันว่าจะหยุดการแต่งข้อมูลหรือแทนการควบคุมสิทธิ์ได้ แนวทาง Fine-Tuning ของ Google
เส้นทางเริ่มฝึกที่ทำซ้ำได้
ใช้ Gemma 4 Fine-tuning Guide ของ Unsloth ซึ่งระบุรองรับ E2B, E4B, 12B, 26B A4B และ 31B แล้วเลือก notebook ให้ตรงชนิดข้อมูล สำหรับการเริ่มแบบข้อความ ใช้ E4B Text notebook เป็นจุดเริ่ม หากต้องฝึก 12B ให้ตรวจ recipe และ dependencies ที่รองรับ 12B ในคู่มือปัจจุบัน ไม่ควรเปลี่ยนเพียง model ID ใน notebook เก่าทุกกรณี
- คัดตัวอย่างที่มีสิทธิ์ใช้และมีคำตอบที่ผู้เชี่ยวชาญตรวจแล้ว แยก train, validation และ test ตามเอกสาร ลูกค้า หรือช่วงเวลา เพื่อไม่ให้ข้อความจากต้นฉบับเดียวกันรั่วข้ามชุด
- เปิด GPU runtime แล้วรันส่วนติดตั้งของ notebook ตามลำดับ บันทึก revision ของ notebook, รุ่น GPU, package versions, model revision และ seed เก็บสำเนา notebook ที่ใช้จริงในที่เก็บงานภายใน
- รัน baseline ด้วยโมเดลเดิมและ test set ที่ล็อกไว้ก่อน แยกงานที่ต้องตอบ งานที่ต้องปฏิเสธ และงานกำกวมที่ต้องถามเพิ่ม
- เตรียมข้อมูลตาม schema ของ notebook เลือก text-only ในการทดลองแรกหากโจทย์เป็นข้อความ เริ่ม context สั้นและ batch เล็ก แล้ววัด VRAM สูงสุดก่อนเพิ่มขนาด
- ฝึกระยะสั้นเพื่อเช็ก loss, masking และรูปแบบคำตอบ อย่าตัดสินจาก training loss เพียงอย่างเดียว จากนั้นเทียบ adapter กับ baseline ด้วย test set เดิม
- บันทึก adapter และ processor หรือ tokenizer ตาม notebook โดยเก็บ base model revision คู่กัน หาก merge หรือ export เป็น GGUF ให้ทดสอบไฟล์ที่ export แล้วอีกครั้งบน runtime ปลายทาง
ตัวอย่างข้อมูลต่อไปนี้แสดงแนวคิดคู่คำถามกับคำตอบ เป็นข้อมูลสมมติและยังต้องแปลงให้ตรง schema ของ notebook ที่เลือก
{
  "messages": [
    {"role": "user", "content": "Classify: the delivered quantity is lower than the purchase order."},
    {"role": "assistant", "content": "quantity_mismatch"}
  ]
}
Unsloth มี notebook แยกสำหรับข้อความ ภาพ และเสียง เพราะ data collator และการเตรียมตัวอย่างต่างกัน อย่าใช้สูตร VRAM ของ text-only เป็นคำรับรองการฝึกภาพหรือเสียง สำหรับ 12B ที่ใช้แกนร่วมกัน ให้ประเมินด้วยว่าการฝึกงานหนึ่งทำให้ความสามารถอีกงานลดลงหรือไม่
หากต้องการเส้นทาง Transformers, PEFT และ TRL โดยตรง ให้ใช้ Google QLoRA guide เป็นคู่มือ framework โดยอ่านหมายเหตุเรื่องรุ่นต้นแบบและฮาร์ดแวร์ด้วย ตัวอย่างที่ออกแบบสำหรับโมเดลเล็กบน T4 ไม่ใช่หลักฐานว่า 12B จะฝึกด้วย configuration เดียวกันได้
ออกแบบ pilot เอกสารกับเสียงในองค์กร
สมมติฝ่ายจัดซื้อต้องตรวจใบเสนอราคาที่เป็นภาพร่วมกับเสียงอธิบายของพนักงาน เป้าหมายทดลองคือให้คนตรวจงานได้เร็วขึ้นโดยยังย้อนกลับไปดูต้นฉบับได้ ตัวอย่างนี้เป็นข้อเสนอวิธีทดลอง ไม่ใช่ระบบที่ Enersys ประกาศว่าเปิดใช้แล้ว
เริ่มจากใบเสนอราคาจำลองหรือเอกสารที่ลบข้อมูลระบุตัวบุคคลแล้ว และเสียงสั้นที่ผู้พูดอนุญาตให้ใช้ กำหนดผลลัพธ์เพียงเลขที่เอกสาร ยอดเงิน เงื่อนไขส่งมอบ และรายการที่ยังต้องถาม อย่าเชื่อมเข้าคำสั่งสร้างเจ้าหนี้หรือจ่ายเงินจริงในรอบแรก
เทียบ E4B กับ 12B บนเครื่องเดียวกันและข้อมูลชุดเดียวกัน ถ้าจะเพิ่ม 26B A4B ให้เทียบเฉพาะเส้นทางข้อความและภาพ หรือใช้ transcript จากระบบเสียงตัวเดียวกันเพื่อให้การเปรียบเทียบมีเงื่อนไขชัดเจน
| สิ่งที่วัด |
หลักฐานที่ต้องเก็บ |
ผู้ตัดสิน |
| เลขเอกสาร ยอดเงิน และสกุลเงินถูกหรือไม่ |
ผลเทียบรายช่องกับเฉลย รวมช่องที่ไม่พบ |
เจ้าของงานจัดซื้อ |
| ข้อความหรือเสียงที่ไม่ชัดทำให้เดาหรือไม่ |
กรณีอ่านไม่ออก เสียงรบกวน และการขอข้อมูลเพิ่ม |
ผู้ตรวจเอกสารและผู้ตรวจเสียง |
| รอคำตอบได้นานเท่าไร |
เวลาเริ่มตอบ เวลาจบ p50/p95 และจำนวนคำขอพร้อมกัน |
ทีมระบบและผู้ใช้งาน |
| ใช้ทรัพยากรและแรงคนเท่าไร |
RAM/VRAM สูงสุด ค่าเครื่อง และเวลาตรวจแก้ |
ผู้รับผิดชอบงบ |
| ข้อมูลและคำสั่งถูกจำกัดสิทธิ์หรือไม่ |
ผลทดสอบข้ามสิทธิ์ การบันทึก log และการลบข้อมูล |
เจ้าของข้อมูลและทีมความปลอดภัย |
กำหนดเกณฑ์ผ่านก่อนเริ่ม เช่น ช่องยอดเงินต้องให้คนตรวจทุกครั้ง และข้อมูลที่ไม่พบต้องไม่ถูกเติมเอง ตัวเลขเป้าหมายความแม่นยำหรือเวลารอควรตั้งจากความเสียหายที่ธุรกิจยอมรับได้ ไม่ใช่คัดลอกจาก benchmark สาธารณะ
ให้เอกสารและเสียงเป็นข้อมูลที่ไม่เชื่อถือ คำสั่งที่ฝังในเอกสารต้องไม่เปลี่ยนสิทธิ์หรือสั่งเครื่องมือได้ เก็บเฉพาะ log ที่จำเป็น กำหนดผู้เข้าถึง ระยะเก็บ และผู้อนุมัติส่งข้อมูลออกนอกระบบ หากใช้ cloud notebook เพื่อฝึก ต้องตรวจเส้นทางข้อมูลแยกจากการรัน inference ในองค์กร
License และสิ่งที่ต้องตรวจเมื่อขยายใช้
Gemma 4 ระบุ Apache 2.0 ซึ่งเปิดทางให้ใช้และดัดแปลงเชิงพาณิชย์ได้ภายใต้เงื่อนไข license เมื่อแจกจ่ายสำเนาหรืองานดัดแปลง ต้องปฏิบัติตามเงื่อนไขเรื่องสำเนา license การแจ้งการแก้ไข และ notices ที่เกี่ยวข้อง รวมถึงไม่มีการรับประกันตามเงื่อนไขที่ระบุ อ่าน Apache 2.0 ที่ Google เผยแพร่สำหรับ Gemma 4
License ของโมเดลไม่ได้ให้สิทธิ์ในเอกสารลูกค้า เสียงพนักงาน เครื่องหมายการค้า หรือข้อมูลส่วนบุคคลโดยอัตโนมัติ ก่อนใช้งานจริงให้ผู้รับผิดชอบตรวจสิทธิ์ข้อมูล ข้อสัญญา เงื่อนไขผู้ให้บริการ และข้อกฎหมายที่ใช้กับงานนั้น การรันในเครื่องช่วยเลือกที่ประมวลผลได้ แต่ยังต้องตรวจ telemetry, logs, backups และเส้นทางที่แอปเรียกออกไปด้วย
ก่อนขยายจาก pilot ให้ระบุเวอร์ชันโมเดลและ runtime ที่อนุมัติไว้ ตั้งเพดาน context และจำนวนงานพร้อมกัน ทดสอบโหลดจริง มี authentication และ rate limit ที่ชั้นบริการ กำหนดคนรับผิดชอบข้อผิดพลาด และเตรียม rollback ไปโมเดลเดิม หากใช้ vLLM หรือระบบ serving อื่น ให้ตรวจการรองรับรุ่นและ quantization ก่อนเลือก image สำหรับ deploy
การตัดสินใจที่ใช้ได้หลังอ่านคู่มือนี้คือเลือกหนึ่งงานและสองรุ่นมาทดลองด้วยเกณฑ์เดียวกัน หาก 12B ให้คุณภาพเพิ่มแต่คนยังต้องแก้ยอดเงินทุกใบ ให้แก้สาเหตุของความผิดพลาดก่อนซื้อเครื่องเพิ่มหรือเริ่ม Fine-Tuning