สรุปสั้นก่อนเริ่ม
เมษายน 2026 ประเทศไทยเปิดตัว ThaiLLM อย่างเป็นทางการ — โครงการ Sovereign AI ระดับชาติที่รวม 4 โมเดลภาษาไทย ฝึกด้วยข้อมูลกว่า 100 พันล้าน tokens รันบน supercomputer ของไทยเอง (ThaiSC LANTA) เปิดให้ใช้ API ฟรีในช่วงเปิดตัว
สิ่งที่คนจะถามทันทีคือ "แล้วมันใช้แทน ChatGPT ได้ไหม?" คำตอบสั้นๆ คือ ใช้แทนไม่ได้ในทุกงาน แต่ใช้แทนได้ในหลายงาน และในบางงานมันยัง ทำได้ดีกว่า Claude หรือ GPT เสียอีก
บทความนี้สรุปสิ่งที่คนทำธุรกิจไทยควรรู้:
- ThaiLLM คืออะไร ใครพัฒนา รันที่ไหน
- 4 โมเดลในตระกูล แต่ละตัวเหมาะกับงานอะไร
- ทำไม "Sovereign AI" ถึงสำคัญในยุค PDPA
- จุดแข็งและจุดอ่อนเมื่อเทียบกับ Claude/GPT
- เริ่มใช้งานจริงยังไง — Practical guide
- Use cases ที่เหมาะ และที่ยังไม่เหมาะ
- ผลกระทบต่อธุรกิจไทยและ Software House
ผมจะเล่าแบบตรงไปตรงมา ไม่เชียร์เกินจริง และไม่ดูถูกของเราเอง
วันที่ AI สัญชาติไทยมาถึงจริงๆ
ลองนึกภาพนี้ — บริษัทบัญชีกลางๆ ในกรุงเทพ พนักงานคนหนึ่งถาม ChatGPT ว่า "ภาษีเงินได้บุคคลธรรมดา 2025 ลดหย่อนค่าเลี้ยงดูบิดามารดาได้เท่าไหร่ และมีเงื่อนไขอย่างไร"
ChatGPT ตอบมาด้วยความมั่นใจ — ยกตัวเลข ยกมาตรา ยกเงื่อนไข สวยหรู
แต่ตัวเลขที่ตอบมา ผิด — เพราะมันไปดึงข้อมูลปี 2022 มาตอบ และผสมกับข้อมูลของกฎหมายต่างประเทศที่หน้าตาคล้ายๆ กัน
นี่คือสิ่งที่เกิดขึ้นจริงในออฟฟิศไทยทุกวัน — ไม่ใช่เพราะ ChatGPT โง่ แต่เพราะมันถูกสร้างมาเพื่อโลกที่พูดอังกฤษเป็นหลัก ภาษาไทยเป็น "ภาษาที่ 30 กว่าๆ" ในตารางความสำคัญของบริษัทเหล่านั้น
ปัญหาไม่ใช่แค่เรื่องภาษา — แต่คือเรื่อง บริบท
- ภาษาราชการไทยมีโครงสร้างเฉพาะ
- กฎหมายไทยมีคำศัพท์ที่ไม่มีในภาษาอื่น
- วัฒนธรรมการสื่อสารไทย (เกรงใจ ออมชอม สุภาพ) แตกต่างจากตะวันตก
- ข้อมูลภาษาไทยใน training data ของ frontier models น้อยกว่า 1% ของทั้งหมด
นี่คือเหตุผลที่ ThaiLLM เปิดตัวมาแล้วน่าจับตา — มันไม่ใช่แค่ "ChatGPT เวอร์ชันไทย" แต่คือ โครงสร้างพื้นฐานทางปัญญา ที่ออกแบบมาเพื่อบริบทไทยตั้งแต่แรก
ThaiLLM คืออะไร — เร็วๆ
ThaiLLM คือโครงการ Sovereign AI แห่งชาติของไทย เปิดตัวอย่างเป็นทางการเดือนเมษายน 2026 โดยความร่วมมือของ:
- MHESI — กระทรวงการอุดมศึกษา วิทยาศาสตร์ วิจัยและนวัตกรรม
- NSTDA / NECTEC — สำนักงานพัฒนาวิทยาศาสตร์และเทคโนโลยีแห่งชาติ
- DEF — กองทุนพัฒนาดิจิทัลเพื่อเศรษฐกิจและสังคม
- พันธมิตรเอกชน: SCB 10X, KBTG, AIEAT, VISTEC
ทีมพัฒนามีคนมากกว่า 700 คน — ทั้งนักวิจัย นักพัฒนา และนักศึกษาที่ผ่านการอบรม
สเปคหลัก:
- 2 ขนาดโมเดล: 8B parameters (เร็ว เบา) และ 30B parameters (ประสิทธิภาพสูง)
- ฝึกด้วยข้อมูลภาษาไทยคุณภาพสูงกว่า 100 พันล้าน tokens (เอกสารราชการ งานวิจัย ข้อความกฎหมาย)
- รันบน ThaiSC LANTA — supercomputer ของไทย ไม่พึ่ง cloud ต่างประเทศ
- API ใช้รูปแบบ OpenAI SDK-compatible — code เดิมแทบไม่ต้องแก้
- ฟรี ในช่วงเปิดตัว (rate limit 5 req/s, 200 req/min)
- Endpoint: playground.thaillm.or.th
- เน้น Agentic AI capabilities ไม่ใช่แค่ chat ตอบคำถาม
จุดที่น่าสนใจคือ — ภายใน ThaiLLM มี 4 โมเดลที่พัฒนาแยกกันโดย 4 องค์กร แต่ใช้ infrastructure และ leaderboard เดียวกัน เพื่อให้ผู้ใช้เลือกตามความเหมาะสม
ทำไมต้องมี Sovereign AI?
คำว่า "Sovereign AI" ฟังดูเหมือนเรื่องการเมืองหรือชาตินิยม แต่จริงๆ มันคือเรื่อง ธุรกิจล้วนๆ ที่ส่งผลตรงต่อต้นทุน ความเสี่ยง และการ comply กับกฎหมาย
1. PDPA + Cross-border data transfer
เมื่อคุณส่ง prompt ไปที่ ChatGPT, Claude, หรือ Gemini — ข้อมูลนั้นวิ่งออกนอกประเทศไทย ไปประมวลผลที่ data center ของบริษัทแม่ในสหรัฐฯ
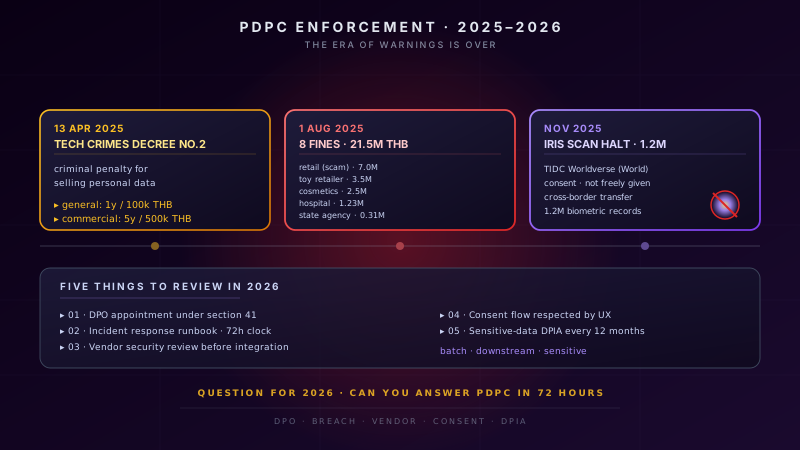
ถ้า prompt มีข้อมูลส่วนบุคคลของลูกค้า (ชื่อ เลขบัตร เบอร์โทร) นั่นคือ cross-border data transfer ภายใต้ PDPA ที่ต้องมีการขออนุญาตหรือมีฐานทางกฎหมายรองรับ
หลายองค์กรไทยใช้ AI โดยไม่รู้ว่ากำลังละเมิด PDPA อยู่ — เพราะคิดว่า "แค่ถามคำถาม ไม่ใช่การส่งข้อมูล"
ThaiLLM ประมวลผล "ในไทยเท่านั้น" — ลด risk นี้ลงทันที
2. ค่าเงินบาทอ่อนทำให้ AI แพงขึ้น
API subscription ของ frontier models คิดราคาเป็น USD เมื่อบาทอ่อน ค่าใช้จ่ายเพิ่มขึ้นโดยที่คุณไม่ได้ใช้งานเพิ่ม
สำหรับ SME ที่ค่า API หลักหมื่นต่อเดือน ความผันผวนของอัตราแลกเปลี่ยนกระทบ budget โดยตรง
ThaiLLM ฟรี (ตอนนี้) และในอนาคตถ้าจะเก็บเงินก็คงคิดเป็นบาท — ไม่ต้องกังวลเรื่องค่าเงิน
3. Cultural และ Linguistic accuracy
ภาษาไทยไม่ได้มีแค่ "ภาษาเดียว" — มันมี:
- ภาษาราชการ (ใช้ในเอกสารทางการ)
- ภาษาธุรกิจ (ใช้ในรายงาน ประชุม)
- ภาษาทั่วไป (ใช้ในชีวิตประจำวัน)
- ภาษาวัยรุ่น (เปลี่ยนทุกปี)
- ภาษาถิ่น (เหนือ อีสาน ใต้)
frontier models เก่งภาษาไทยกลางๆ ใช้งานได้ แต่ถ้าต้องเขียนเอกสารทางการที่ใช้คำว่า "ขอเรียนเชิญ" "พร้อมนี้ได้แนบ" "ด้วยเหตุนี้จึงเรียนมาเพื่อโปรดทราบและพิจารณาดำเนินการต่อไป" — ThaiLLM ทำได้เป็นธรรมชาติกว่า
4. Data Sovereignty ในระดับชาติ
ในยุคที่หลายประเทศกังวลเรื่อง AI dependency จากบริษัทต่างชาติ — Sovereign AI คือทางออกระยะยาว
ถ้าวันหนึ่ง OpenAI ขึ้นราคา 10 เท่า หรือ block การเข้าถึงจากบางประเทศ องค์กรที่ฝังตัวเองอยู่กับ frontier models จะเจอ supply chain risk ทันที
ThaiLLM = backup plan ระดับประเทศ
4 โมเดลของ ThaiLLM — ใครเหมาะกับงานไหน
ภายใต้ร่ม ThaiLLM มี 4 โมเดลที่พัฒนาแยกกัน แต่ใช้ infrastructure ร่วม ทุกตัวเป็น 8B parameters เป็นหลัก แตกต่างกันที่ training data และ fine-tuning approach
1. OpenThaiGPT-ThaiLLM-8B-Instruct-v7.2 (โดย AIEAT)
- จุดแข็ง: General purpose, community-driven, version evolution ต่อเนื่อง
- เหมาะกับ: chatbot ทั่วไป, content generation, prototype งานต่างๆ
- เหตุผล: AIEAT (Artificial Intelligence Entrepreneur Association of Thailand) เป็นชุมชนนักพัฒนา — model evolve ตามความต้องการของตลาด
2. Pathumma-ThaiLLM-qwen3-8b-think-3.0.0 (โดย NECTEC)
- จุดแข็ง: รองรับ "thinking" mode (chain-of-thought), bias ไปทางวิจัย/วิชาการ
- เหมาะกับ: งานวิเคราะห์เอกสารยาว, สรุปงานวิจัย, ตอบคำถามแบบมีเหตุผล
- เหตุผล: NECTEC เป็นหน่วยวิจัยภาครัฐ — เน้น quality และ explainability มากกว่า throughput
3. Typhoon-S-ThaiLLM-8B-Instruct (โดย SCB 10X)
- จุดแข็ง: ฝึกบนข้อมูลธุรกิจ การเงิน fintech
- เหมาะกับ: chatbot สำหรับธนาคาร, customer service ในธุรกิจการเงิน, document understanding ทางการค้า
- เหตุผล: SCB 10X เป็น tech arm ของ SCB ซึ่งมี domain expertise ในด้านการเงินสูงมาก
4. THaLLE-0.2-ThaiLLM-8B-fa (โดย KBTG)
- จุดแข็ง: ฝึกเฉพาะ banking/financial domain
- เหมาะกับ: งาน compliance, risk analysis, หรือ workflow ภายในธนาคาร
- เหตุผล: KBTG เป็น tech arm ของ KBank — มีประสบการณ์ regulated financial AI สูง
วิธีคิดเลือกใช้งาน
อย่ามองที่ "โมเดลไหนเก่งสุด" — ให้มองที่ use case ของคุณ
- งานทั่วไป + chatbot → OpenThaiGPT
- งานเอกสาร + วิจัย → Pathumma
- งานธุรกิจ + การเงิน → Typhoon-S
- งาน banking + regulated → THaLLE
ดีที่สุดคือ — ลองทุกตัวกับ prompt จริงของคุณ แล้วดูผล ใช้ playground ฟรี
เทียบกับ Claude/GPT — จุดแข็งและจุดอ่อนตรงไหน
นี่คือส่วนที่คนอยากรู้มากที่สุด เลยขอตรงไปตรงมา
ThaiLLM ชนะเมื่อ
- Thai-specific facts: จับข้อมูลไทย (กฎหมาย ระเบียบ มาตรา) แม่นยำกว่า
- ภาษาราชการ: เขียนเอกสารทางการได้ธรรมชาติกว่า
- Data sovereignty: ข้อมูลไม่ออกประเทศ = PDPA-friendly
- ค่าใช้จ่าย: ฟรีตอนนี้ และอนาคตน่าจะถูกกว่า frontier models
- ความเสถียรของบาท: ราคาคิดเป็นบาท ไม่ผันผวนตามค่าเงิน
- Community ไทย: support ภาษาไทย, มี community local
Claude / GPT ชนะเมื่อ
- Creative writing: เขียนนิยาย เขียนบทความสร้างสรรค์ระดับสูง
- Content ภาษาอังกฤษ: ครอบคลุมและลึกกว่า
- Multimodal: image, audio, video — ThaiLLM ยังไม่มี
- Long context: Claude มี 200K tokens — ThaiLLM ยังเล็กกว่ามาก
- Agentic tools ลึกๆ: tool use, code execution, computer use
- Scale & SLA: production-grade infrastructure, enterprise SLA
- General world knowledge: ครอบคลุมทุกหัวข้อทั่วโลก
ข้อสรุปที่สำคัญ
จากการทดสอบของ humansneednot — ThaiLLM 8B แสดงให้เห็นว่า เข้าใจข้อมูลภาษาไทยและข้อเท็จจริงในบริบทไทยได้ดีกว่า Claude Sonnet ในหลาย task แต่ Claude ยังเก่งกว่าด้าน creative narrative และ general reasoning
บทสรุป: complement rather than directly compete — ใช้ร่วมกัน ไม่ใช่แทนที่กัน
ถ้าคุณคิดแบบ "เลือกฝั่งใดฝั่งหนึ่ง" คุณกำลังคิดผิด — บริษัทที่ฉลาดจะใช้ทั้งสองอย่างร่วมกัน
เริ่มใช้งานยังไง — Practical Guide
Step 1: ทดลองที่ Playground ก่อน
เข้า playground.thaillm.or.th ลองพิมพ์ prompt จริงของงานคุณ — ทดสอบทั้ง 4 โมเดล เปรียบเทียบผลลัพธ์
อย่าเพิ่งกระโดดไปเชื่อมต่อ API — เพราะแต่ละโมเดลตอบไม่เหมือนกัน คุณต้องรู้ก่อนว่าโมเดลไหนเหมาะกับงาน
Step 2: ลงทะเบียน API key
ผ่าน portal ของ ThaiLLM — ใช้รูปแบบ OpenAI SDK-compatible แปลว่าถ้าคุณใช้ openai library อยู่แล้ว เปลี่ยนแค่ base URL กับ API key ก็พร้อมใช้
นี่คือจุดที่ทีมพัฒนาทำดีมาก — ไม่ต้องเรียน SDK ใหม่
Step 3: รู้ขีดจำกัด Rate limit
- 5 requests ต่อวินาที
- 200 requests ต่อนาที
ตัวเลขนี้ เพียงพอสำหรับ pilot หรือ internal tools แต่ไม่พอสำหรับ production-scale customer-facing application
ถ้าจะใช้ระดับ production ต้องวางแผน:
- Caching layer หน้า API
- Queue system ป้องกัน burst traffic
- Fallback ไป frontier models เมื่อ rate limit
Step 4: ถ้าต้อง scale — Download model
ThaiLLM เปิดให้ download model สำหรับรัน on-premise หรือบน cloud ของตัวเอง
นี่คือทางเลือกสำหรับองค์กรขนาดใหญ่ — รันเองบน GPU ของบริษัท ไม่ต้องห่วง rate limit แต่ต้องลงทุน infrastructure
Caveat: ฟรีตอนนี้ — แต่อนาคต?
ฟรีในช่วงเปิดตัวเป็นเรื่องดี แต่อย่าวาง business plan ระยะยาวบนสมมติฐานนี้
วิธีที่ปลอดภัยกว่า:
- Pilot ฟรีตอนนี้
- ประเมิน ROI จริง
- วาง budget เผื่อไว้สำหรับ commercial pricing
- Compare กับต้นทุน frontier models เพื่อเปรียบเทียบ
Use Cases ที่เหมาะกับ ThaiLLM
จากการประเมินจริง — งานเหล่านี้ ThaiLLM ทำได้ดีและคุ้มค่า
1. Customer service chatbot ภาษาไทย
ลูกค้าคนไทยถามเป็นภาษาไทย ตอบเป็นภาษาไทย — งานนี้ ThaiLLM ทำได้ดีกว่า frontier models โดยไม่ต้องส่งข้อมูลออกประเทศ
2. การสรุปและวิเคราะห์เอกสารราชการ/กฎหมาย
ระเบียบกระทรวง ประกาศ ข้อบังคับ — ภาษาราชการที่ frontier models มักตีความผิด ThaiLLM (โดยเฉพาะ Pathumma) จับ context ได้ดีกว่า
3. Internal tools ที่ต้องการ data sovereignty
HR systems, finance reports, legal review — ข้อมูลที่ "ไม่ควรหลุดออกนอกองค์กร เลยไม่ควรหลุดออกนอกประเทศด้วย"
4. งานวิจัย NLP ภาษาไทย
นักวิจัยและนักศึกษาไทยที่ทำงานด้าน NLP — ตอนนี้มี baseline model ภาษาไทยที่ใช้เปรียบเทียบได้ฟรี
5. Hybrid workflow
ใช้ ThaiLLM สำหรับ Thai-specific tasks + Claude/GPT สำหรับ English/global content + Vision tasks — ผสมกันให้ได้สิ่งที่ดีที่สุดของทั้งสองโลก
Use Cases ที่ยังไม่เหมาะ
ตรงนี้สำคัญ — อย่าใช้ ThaiLLM กับงานที่ไม่ใช่ความสามารถมัน
1. งานที่ต้องการ creative writing ระดับสูง
นิยาย บทละคร poetry — Claude/GPT ยังเก่งกว่ามาก เพราะถูกฝึกบน creative content จำนวนมหาศาล
2. งานที่ต้องการ context ยาวมาก
วิเคราะห์เอกสาร 100+ หน้าในรอบเดียว — Claude มี 200K context window, ThaiLLM 8B ยังเล็กกว่ามาก
3. งาน multimodal
รูปภาพ เสียง วิดีโอ — ThaiLLM ตอนเปิดตัวยังเป็น text-only ถ้าต้องการ vision/audio ต้องใช้ frontier models
4. งาน agentic ลึกๆ
ใช้ tool, browse web, run code — ecosystem ของ Claude Managed Agents หรือ GPT function calling ยังพัฒนามากกว่า
5. Production scale ที่ต้องการ SLA
99.99% uptime, enterprise contract, dedicated support — ตอนนี้ ThaiLLM ยังอยู่ในเฟสเปิดตัว ไม่มี SLA ชัดเจนสำหรับ enterprise
ผลกระทบต่อ Software House และธุรกิจไทย
จากมุมของบริษัทที่ทำซอฟต์แวร์ในไทย — ThaiLLM เปลี่ยนสมการหลายอย่าง
1. Cost optimization โดยตรง
บริษัทที่จ่ายค่า OpenAI/Anthropic API หลักแสนต่อเดือน — สามารถ migrate งาน Thai-language workload ไป ThaiLLM ลดต้นทุนได้ทันที (ระหว่างที่ยังฟรี) และวาง budget ระยะยาว
2. PDPA compliance ง่ายขึ้น
ข้อมูล personal data ที่เคยกังวลเรื่อง cross-border transfer — ตอนนี้มีทางเลือกที่ "stays in Thailand"
ตัว AI tool เปลี่ยนจาก compliance liability เป็น compliance solution
3. New service offering
Software house สามารถเสนอบริการใหม่ — "Thai-first AI products" ที่ใช้ Sovereign AI infrastructure
ลูกค้าราชการและรัฐวิสาหกิจที่เคยลังเลเรื่อง data ออกประเทศ — ตอนนี้มี option
4. Risk: lock-in กับ government infrastructure
อย่ามองด้านดีอย่างเดียว — การพึ่งพา infrastructure ที่ run โดยรัฐมีความเสี่ยงเหมือนกัน
- รัฐบาลเปลี่ยน นโยบายอาจเปลี่ยน
- งบประมาณ ThaiSC อาจถูก cut ในอนาคต
- Roadmap ของโมเดลขึ้นกับการตัดสินใจของหน่วยงานราชการ
วิธีจัดการ: อย่าผูกตัวเองกับ ThaiLLM 100% — ใช้ multi-model strategy เสมอ
5. Long-term: Thai tech ecosystem แข็งแรงขึ้น
มี baseline model ภาษาไทยให้ทุกคนใช้ได้ = barrier to entry ลดลง
นักพัฒนาไทยสามารถสร้างผลิตภัณฑ์ AI โดยไม่ต้องผ่าน foundation model ต่างประเทศ — นี่คือสิ่งที่จะส่งผลในระยะ 3-5 ปีข้างหน้า
สิ่งที่ต้องระวัง
ถ้าคุณกำลังจะรับ ThaiLLM เข้าไปใน workflow — มี 6 เรื่องที่ต้องเตือนก่อน
1. Quality varies by task
โมเดลเดียวกัน task ต่างกัน คุณภาพต่างกันมาก อย่าสรุปจาก use case เดียว
2. Limited context window
ถ้า workflow ของคุณต้องอ่านเอกสารยาวมาก — ตรวจสอบ context window ก่อน อย่าเพิ่ง assume ว่าใหญ่เท่า frontier models
3. Rate limits ไม่ production-ready
5 req/s = พอสำหรับ internal tools แต่ไม่พอสำหรับ public-facing application ที่มีผู้ใช้พร้อมกันหลายร้อยคน
4. No clear enterprise SLA
ตอนนี้ยังไม่มีสัญญาระดับ enterprise — ถ้าระบบล่ม ใครรับผิดชอบ? ใครให้ support? คำตอบยังไม่ชัด
5. Roadmap uncertainty
โครงการที่พึ่งงบประมาณรัฐ — มี political risk เสมอ อย่าวาง business critical operation ทั้งหมดบน foundation นี้
6. อย่าใช้ blind
ก่อน deploy ทุกครั้ง — ทดสอบกับ use case จริงของคุณ เปรียบเทียบกับ baseline (เช่น Claude/GPT) วัดผลทั้ง quality และ latency
ถ้าผลดีพอและตอบโจทย์ → ใช้
ถ้ายังด้อยกว่ามาก → รออัปเดต รอ version ถัดไป
สำหรับทีม Enersys
ในฐานะ software house ที่ทำงานกับลูกค้าไทยทุกวัน — เราประเมิน AI models ตามหลักง่ายๆ:
1. ขึ้นกับ use case ไม่ใช่ hype
โมเดลที่ "ดีที่สุด" ในบทความ — อาจไม่ใช่โมเดลที่ดีที่สุดสำหรับลูกค้าคุณ เราทดสอบทุก model กับ workload จริงก่อนแนะนำ
2. Multi-model approach
เราไม่เคยแนะนำลูกค้าให้ผูกกับโมเดลเดียว — Claude สำหรับ reasoning, GPT สำหรับ general, Gemini สำหรับ multimodal, ตอนนี้เพิ่ม ThaiLLM สำหรับ Thai-specific และ data sovereignty
3. PDPA-first design
สำหรับลูกค้าที่ต้องการ compliance สูง — Sovereign AI = ทางออกใหม่ที่เราจะนำมาประเมินเป็น default option สำหรับ workload ที่มี personal data
4. ไม่ vendor lock-in
เราออกแบบ architecture ที่ swap model ได้โดยไม่ต้อง rewrite ทั้งระบบ — เพราะรู้ว่า AI landscape เปลี่ยนเร็ว สิ่งที่ดีที่สุดวันนี้อาจไม่ใช่สิ่งที่ดีที่สุดในอีก 6 เดือน
ThaiLLM ไม่ได้มาแทนที่ frontier models — มันเป็น เพื่อนร่วมทีม ที่เก่งในบางเรื่องและอ่อนในบางเรื่อง เหมือนกับทุกโมเดลในโลกนี้
หน้าที่ของเราคือ — เลือกเครื่องมือที่ใช่ สำหรับงานที่ใช่ ของลูกค้าที่ใช่
สรุป
ThaiLLM คือก้าวสำคัญของไทย — ครั้งแรกที่เรามี Sovereign AI ระดับชาติที่ใช้งานได้จริง ฟรี และรันบน infrastructure ของเราเอง
แต่อย่าเข้าใจผิดว่ามันมาแทนที่ Claude/GPT — มันมา เติมเต็ม ในจุดที่ frontier models อ่อน (Thai context, data sovereignty, cost) และยังมีจุดที่ frontier models เก่งกว่า (creative, multimodal, scale)
สำหรับธุรกิจไทยปี 2026 — ผมแนะนำ:
- ไปลองที่ playground.thaillm.or.th วันนี้ — ฟรี ไม่มีอะไรเสีย
- ทดสอบกับ use case จริงของคุณ — อย่าตัดสินจากบทความ ตัดสินจากผลลัพธ์
- คิดแบบ multi-model — ไม่ต้องเลือกฝั่ง ใช้ทั้งคู่ตามความเหมาะสม
- ระวังเรื่อง data — ใช้ ThaiLLM กับงานที่มี Thai personal data ลด PDPA risk
- อย่าวาง all-in — เก็บ frontier models ไว้เป็น option, อย่า lock-in กับใครคนเดียว
ปีหน้าเราจะเห็น ThaiLLM v2, v3 — ระหว่างนี้คือเวลาที่ดีที่สุดในการเรียนรู้และสร้าง experience กับ Sovereign AI ของไทย
ถ้าทีมของคุณกำลังคิดเรื่องนี้ — นี่คือช่วงเวลาที่ควรเริ่ม ไม่ใช่ช่วงเวลาที่ควรรอ
แหล่งข้อมูล
แหล่งข้อมูลทั้งหมด verify แล้วในวันที่เผยแพร่บทความ ตัวเลขและ specification อาจเปลี่ยนแปลงเมื่อ ThaiLLM ออก version ใหม่