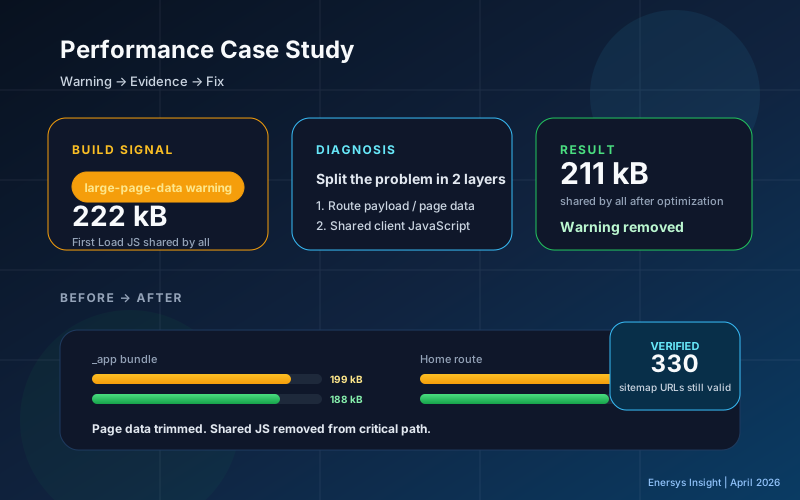
ลูกค้าเปิดหน้าบริการบนมือถือเพื่อดูว่าบริษัทรับงานแบบที่ต้องการหรือไม่ หัวข้อยังไม่ขึ้น พอเนื้อหาปรากฏและกำลังจะแตะปุ่มติดต่อ รูปที่โหลดตามมาดันปุ่มเลื่อนลงไปอีก
สถานการณ์สมมตินี้มีปัญหาคนละอย่างอยู่ในหน้าเดียว การรอเนื้อหา การตอบสนองหลังแตะ และตำแหน่งที่ขยับทำให้คนใช้ทำงานต่อได้ยากขึ้น ต่อให้หน้าเว็บมีข้อมูลถูกต้อง คนอ่านก็ต้องผ่านอุปสรรคเหล่านี้ก่อนจะได้ใช้ข้อมูลนั้น
สำหรับบริษัทที่รับพัฒนาซอฟต์แวร์อย่าง Enersys ความเร็วเว็บจึงเป็นคุณภาพของงานที่ควรรักษาได้ตลอดอายุการใช้งาน งานปรับปรุงครั้งหนึ่งยังไม่จบเรื่อง เพราะภาพใหม่ แบบฟอร์มใหม่ หรือสคริปต์ติดตามตัวใหม่อาจเพิ่มภาระกลับเข้ามาในการปล่อยงานครั้งถัดไป
คำถามที่บทความนี้ชวนทีมตอบคือ เมื่อของที่เพิ่มวันนี้ทำให้เว็บช้าลง ใครจะรู้ก่อนลูกค้า และระบบจะหยุดการปล่อยงานไว้ที่จุดไหน?
เริ่มจากหลักฐานของ workflow เดิม
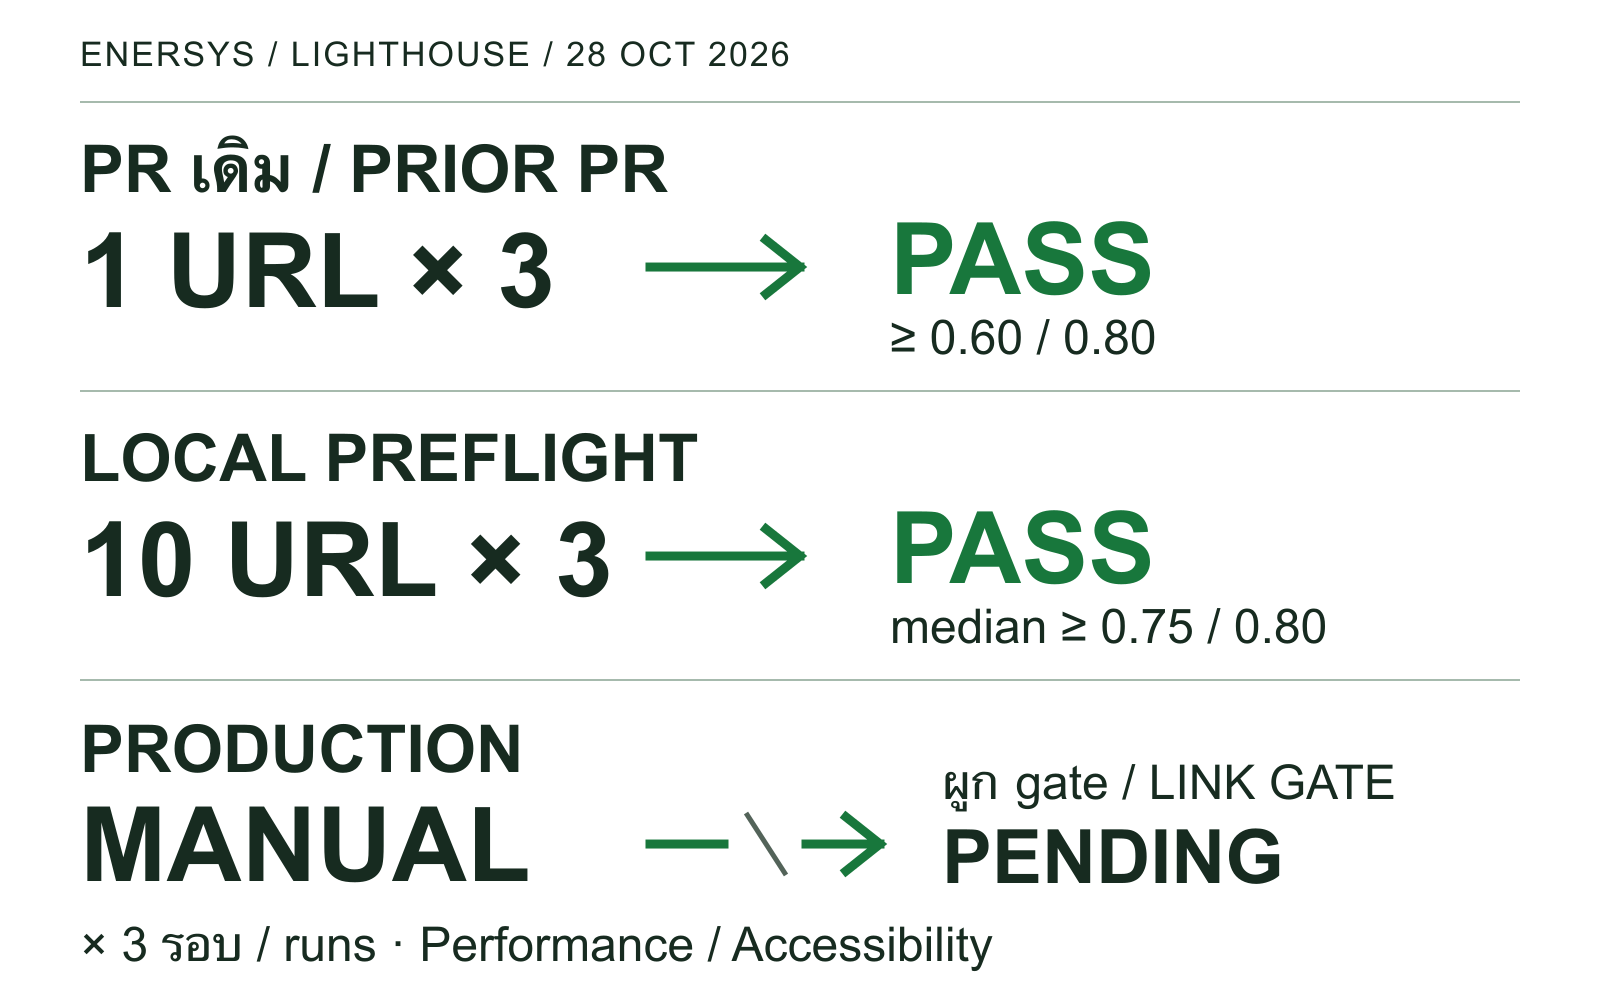
workflow เดิมที่ใช้เป็นฐานก่อนการปรับปรุงวันที่ 28 ตุลาคม 2569 กำหนดใน .github/workflows/lighthouse.yml ให้ตรวจเมื่อเปิด pull request หรือส่งการเปลี่ยนแปลงเข้า pull request ที่มีอยู่ ระบบ build เว็บแบบ static export แล้วตรวจหน้า /th ในเครื่องทดสอบ 3 รอบ
ค่าที่เขียนไว้ให้ Performance ต่ำกว่า 0.60 และ Accessibility ต่ำกว่า 0.80 เป็น error ส่วน Best Practices และ SEO ต่ำกว่า 0.80 เป็น warning ระบบพยายามเก็บรายงานไว้เป็น artifact อายุ 30 วัน และส่ง exit code ของ Lighthouse CI กลับให้ขั้นตอนตรวจ
มีหลักฐานการรัน GitHub Actions จริงหมายเลข 39057394135 ที่จบด้วยสถานะ success ในเดือนตุลาคม 2569 ขั้นตอนที่ตรวจเห็นประกอบด้วย Checkout, Build static export, Serve & audit และ Upload Lighthouse results จึงยืนยันได้ว่า workflow ฝั่ง pull request เคยทำงานสำเร็จ แต่ยังไม่ใช่หลักฐานว่ามี branch protection บังคับก่อน merge หรือผูกผลกับการปล่อย production ภาพประกอบสาธารณะจะใช้ข้อเท็จจริงเหล่านี้โดยไม่เปิดเผยชื่อ repository บัญชี หรือเครื่อง runner ส่วนตัว
อีกจุดที่ต้องแยกกันคือเส้นทาง production ปัจจุบันซึ่งใช้ Rancher และ Harbor มีขั้นอนุมัติแบบ manual แต่ยังไม่ได้ผูกการปล่อยงานให้ขึ้นอยู่กับผล Lighthouse CI ชุดนี้ ไฟล์ release.yml แบบ tag v* ที่ยังอยู่ใน repository เป็นเส้นทาง DigitalOcean เดิม จึงใช้เป็นหลักฐานแทนกระบวนการปล่อย production ปัจจุบันไม่ได้
บทความนี้แยกการตรวจ pull request เดิมออกจาก candidate preflight ที่เพิ่มและทดสอบแล้ว จากนั้นอธิบายงานที่ยังต้องเชื่อมเพื่อให้ production ทุกครั้งขึ้นอยู่กับผลตรวจ ตัวอย่างเกณฑ์ที่เข้มขึ้นและเหตุการณ์ภาพใหม่ทำให้เว็บช้าในช่วงถัดไปเป็นตัวอย่างเพื่ออธิบายวิธีคิด ไม่ใช่ผลของ Enersys
สิ่งที่เพิ่มใน candidate preflight ของ Enersys
ในงานรอบนี้มีการเพิ่มเครื่องมือตรวจ candidate และ workflow ฝั่ง PR/manual ใน commit 6ec17848 โดยต่อจากซอร์สที่ใช้อยู่ใน production จุดต่างจาก workflow เดิมคือระบุ policy ไว้รวมกัน ตรวจความครบของไฟล์และเพดานขนาดก่อนเปิด Chrome แล้วผูกผลตรวจกับ fingerprint ของ static export
ชุดหน้าตัวแทนมี 5 ประเภท ประเภทละภาษาไทยและอังกฤษ รวม 10 URL ได้แก่หน้าแรก หน้าบริการ e-Withholding Tax บทความเทียบ e-Withholding Tax กับ e-Filing บทความยาวเรื่อง page data และ shared JavaScript และเครื่องมือประเมินความพร้อม e-Withholding Tax แต่ละ URL ตรวจ 3 รอบด้วย mobile simulation
| สิ่งที่ policy ใหม่กำหนดจริง |
เกณฑ์ |
| Performance และ Accessibility |
median อย่างน้อย 0.75 และ 0.80 ตามลำดับ |
| ขนาด gzip ของ document / direct JavaScript / direct CSS ต่อหน้า |
ไม่เกิน 50,000 / 300,000 / 40,000 bytes |
| JavaScript ที่รับส่งในการตรวจ browser |
รอบที่มากที่สุดไม่เกิน 300,000 bytes และไม่เกิน 20 scripts |
| CSS ที่รับส่งในการตรวจ browser |
รอบที่มากที่สุดไม่เกิน 40,000 bytes |
| LCP และ TBT |
warning เมื่อเกิน 4,000 ms และ 600 ms ตามลำดับ ยังไม่ใช่เกณฑ์หยุดงาน |
สองชั้นของงบขนาดมีหน้าที่ต่างกัน ชั้นแรกอ่านไฟล์ที่ปล่อยออกมาจริงและ dependencies ที่อ้างอิงโดยตรง ส่วนชั้น browser ดูการรับส่งที่เกิดขึ้นใน Lighthouse จึงไม่ควรนำตัวเลขของสองชั้นมาปะปนกัน เวอร์ชันที่ตรึงไว้คือ Lighthouse CI 0.15.1 และ Lighthouse 12.6.1
ขอบเขตที่ต้องรักษาไว้ในคำอธิบายคือ เครื่องมือนี้เป็น local/PR preflight ที่เพิ่มแล้ว ส่วนเส้นทาง Harbor/Rancher แบบ manual ยังไม่ได้บังคับให้เรียกใช้มันก่อนทุก deployment การพัฒนาเครื่องมือตรวจและการปิดทางข้ามก่อนขึ้น production เป็นงานคนละขั้น
ผลตรวจครบ 10 URL รวม 30 รอบจบด้วยสถานะผ่านเมื่อวันที่ 28 ตุลาคม 2569 เวลา 03:55 น. ตามเวลาไทย โดยตรวจ static export ที่ยืนยันแหล่งซอร์สเป็น f21ae899 ซึ่งเป็นฐาน production ก่อนเพิ่มบทความนี้ ไม่ใช่ผลจาก image ที่กำลังทำงานอยู่หรือ build ใหม่ที่มีบทความฉบับนี้แล้ว
| หน้าที่ตรวจ |
median Performance ไทย / อังกฤษ |
median LCP ไทย / อังกฤษ |
| หน้าแรก |
86 / 87 |
4,213 / 4,065 ms |
| บริการ e-Withholding Tax |
87 / 83 |
3,987 / 3,761 ms |
| บทความ e-Withholding Tax เทียบ e-Filing |
83 / 84 |
4,659 / 4,504 ms |
| บทความยาว page data และ shared JavaScript |
86 / 88 |
4,112 / 3,957 ms |
| เครื่องมือประเมินความพร้อม |
89 / 91 |
3,758 / 3,538 ms |
Accessibility ได้ median 96 ทุก URL คะแนน Performance ในตารางแปลงจากสเกล 0 ถึง 1 เป็น 0 ถึง 100 เพื่อให้อ่านง่าย การวัดใช้ Chrome 156, Lighthouse 12.6.1, mobile viewport 412 × 823, DPR 1.75 และ simulated throttling ที่ RTT 150 ms, throughput 1,638.4 Kbps, CPU slowdown 4 เท่า ควรเก็บ profile นี้ติดกับผลเสมอ
ผลนี้แสดงด้วยว่าการผ่าน gate ยังมีงานเหลือ LCP หลายหน้าเกิน 4,000 ms แต่เป็น warning ตาม policy รอบนี้ จึงไม่หยุด preflight การผ่านเพดานกัน regression ไม่ใช่คำรับรองว่าผ่าน Core Web Vitals ของผู้ใช้จริง
ระบบผูก export 1,817 ไฟล์เข้ากับ SHA-256 ด้านล่าง และตรวจว่าชุดไฟล์กับ policy ไม่เปลี่ยนระหว่างวัด หากจะใช้ผลนี้ประกอบการปล่อยงาน ต้องตรวจ receipt กับไฟล์เดิมอีกครั้งก่อนบรรจุหรือปล่อย ห้าม build ใหม่แล้วอ้างผลเก่า Receipt เป็นหลักฐานภายในกระบวนการ ยังไม่ใช่ attestation ที่ลงลายเซ็นรับรอง provenance
743e4881aa7966bb06de5bb4c9b8d133d41069ec9189c5d90347a6d9fa8eaa37
ทดสอบทางไม่ผ่านด้วย 2 วิธี ได้แก่สร้าง HTML สมมติที่เกินงบขนาด และใช้รายงาน Lighthouse จริงชุด baseline ทดสอบ assertion ที่เข้มขึ้นชั่วคราวให้ minScore เป็น 1.0 ทั้งสองกรณีจบด้วย exit code 1 และคำสั่ง sentinel ที่วางต่อท้ายไม่ได้ทำงาน ข้อนี้ยืนยันการหยุดลำดับคำสั่งทดสอบ ไม่ใช่การทดลอง deploy ที่ล้มเหลวในคลัสเตอร์จริง ชุดข้อมูลสรุปที่ตัดข้อมูลส่วนตัวออกแล้ว
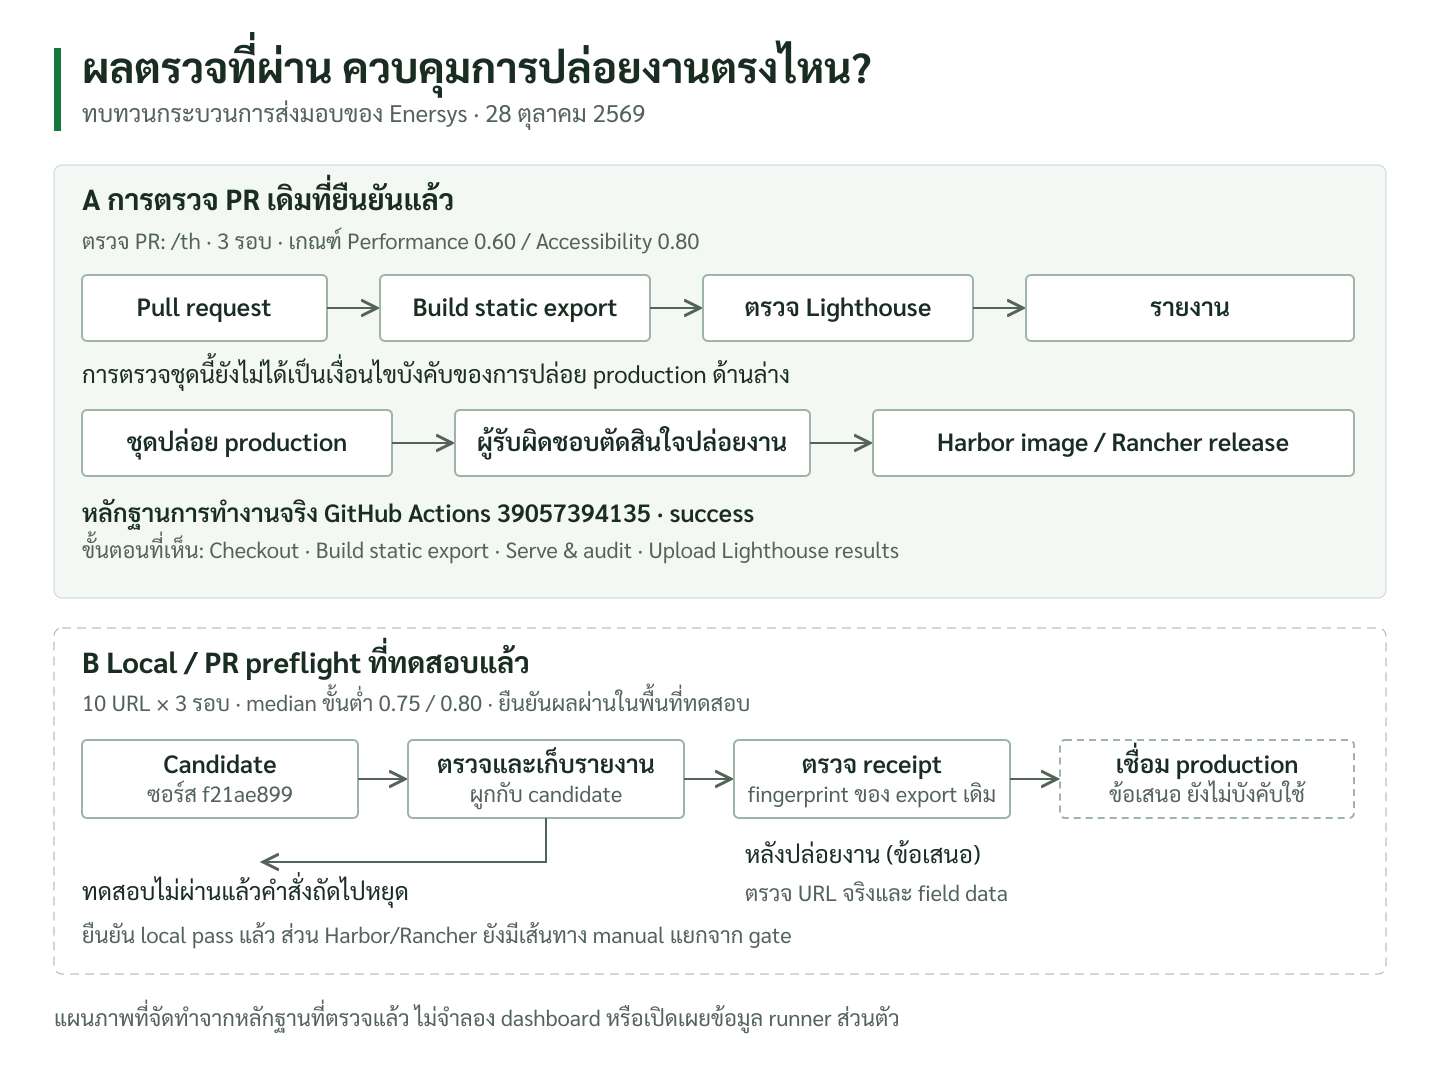 แผนภาพจัดทำจากหลักฐานการรัน PR เดิมและการตรวจ candidate ในพื้นที่แยก 10 URL รวม 30 รอบ ส่วนการเชื่อมให้ Harbor/Rancher บังคับตรวจและการติดตามหลังปล่อยงานยังเป็นข้อเสนอ สถานะ 28 ตุลาคม 2569 ไม่ใช่ภาพหน้าจอ dashboard
วัดสิ่งที่คนใช้รู้สึก ก่อนเลือกคะแนนที่จะเฝ้า
ความเร็วมีหลายด้าน Core Web Vitals กำหนดเกณฑ์ระดับ good ของ LCP ไม่เกิน 2.5 วินาที, INP ไม่เกิน 200 ms และ CLS ไม่เกิน 0.1 โดยดูที่เปอร์เซ็นไทล์ 75 ของประสบการณ์ที่วัดได้ แต่ละตัวสะท้อนการแสดงเนื้อหาหลัก การตอบสนอง และความนิ่งของหน้าเว็บตามลำดับ เกณฑ์ของ Core Web Vitals
ตัวเลขเหล่านี้ช่วยตั้งเป้าหมายของประสบการณ์จริง แต่เวลาทำงานต้องใช้ข้อมูล 2 ชุดให้ถูกหน้าที่
ข้อมูลในห้องทดสอบหรือ lab data ช่วยเทียบการเปลี่ยนแปลงก่อนปล่อยงาน เพราะกำหนดเงื่อนไขให้ใกล้กันได้ ส่วนข้อมูลจากผู้ใช้จริงหรือ field data บอกว่าคนที่เข้ามาใช้งานพบอะไรจริง Lighthouse navigation audit ใช้ TBT ช่วยวิเคราะห์งานที่ขวาง main thread ช่วงโหลดหน้า แต่ TBT ไม่ใช่ INP และไม่ยืนยันการตอบสนองตลอดการใช้งาน เหตุที่ข้อมูล lab และ field ต่างกัน
ข้อเสนอสำหรับทีมคือใช้ lab เป็นสัญญาณก่อนปล่อย แล้วใช้ field ตรวจว่าผลที่รักษาไว้ในเครื่องทดสอบไปถึงผู้ใช้หรือไม่ หาก lab ดีขึ้นแต่คนใช้ยังเจอปัญหา ต้องเปิดการสืบหาสาเหตุต่อ ไม่ควรปิดงานด้วยคะแนนที่ดีขึ้นเพียงตัวเดียว
เลือกหน้าที่ตรวจจากงานของคนใช้
การตรวจหน้า /th เป็นจุดเริ่มต้นที่อ่านผลและดูแลได้ง่าย แต่ไม่พอจะรับรองทุกหน้า หน้าแรกอาจเบา ขณะที่หน้าบริการมีแผนที่ วิดีโอ หรือแบบฟอร์มที่ไม่ปรากฏในหน้าแรก
ก่อนเพิ่มจำนวน URL ให้ทำบัญชีหน้าตัวแทนตามภาระงาน หน้าแรกใช้ดูการนำทางร่วม หน้าบริการใช้ดูจุดเริ่มติดต่อธุรกิจ บทความยาวใช้ดูภาพและฟอนต์ และหน้าที่มีฟอร์มใช้ดูการโต้ตอบ เลือก URL จริงที่ยังใช้อยู่ แล้วบันทึกว่าหน้านั้นแทนความเสี่ยงอะไร
เว็บสองภาษาควรมีหน้าตัวแทนของภาษาไทยและอังกฤษด้วย ความยาวหัวข้อ ฟอนต์ และรูปแบบเนื้อหาอาจต่างกัน การผ่านหน้าไทยไม่ได้เป็นหลักฐานว่าหน้าอังกฤษผ่านตามไปด้วย
ในข้อเสนอนี้ แต่ละ pull request ตรวจชุดหน้าหลักที่ใช้เวลาเหมาะสม ส่วนการตรวจตามกำหนดเพิ่มหน้าที่เหลือหมุนเวียนกันไป เมื่อแก้ component ที่ใช้ร่วมกัน เช่น navigation หรือแบบฟอร์มติดต่อ ให้ตรวจกลุ่มหน้าที่ใช้ component นั้นเพิ่มตามผลกระทบ
ตั้งงบประมาณให้คนออกแบบและคนอนุมัติเห็นต้นทุนเดียวกัน
Performance budget คือเพดานที่ทีมตกลงก่อนเพิ่มของเข้าหน้าเว็บ เช่น เวลาแสดงเนื้อหา งานที่ขวางการตอบสนอง และปริมาณ JavaScript ที่ต้องรับส่ง การตัดสินใจเรื่องภาพหรือ widget จะชัดขึ้นเมื่อเห็นว่าของใหม่ใช้พื้นที่ในงบเท่าไร
ค่าตารางต่อไปนี้เข้มกว่า policy จริงด้านบน เป็นตัวอย่างสำหรับเริ่มคุย ต้องวัด baseline ในสภาพแวดล้อมที่กำหนดก่อนนำไปใช้ ไม่ใช่ค่าที่ตรวจพบจาก production ของ Enersys
| สิ่งที่ตรวจใน lab |
ตัวอย่างเกณฑ์ที่เสนอ |
วิธีใช้ตัดสินใจ |
| Lighthouse Performance |
อย่างน้อย 0.85 |
ใช้เป็นสัญญาณรวม แล้วเปิดดู metric ที่เปลี่ยน |
| LCP |
ไม่เกิน 3,500 ms |
ตรวจผลของเนื้อหาหลักภายใต้ profile ทดสอบที่ระบุ |
| TBT |
ไม่เกิน 300 ms |
เตือนว่างานช่วงโหลดหน้าอาจขวางการโต้ตอบ |
| CLS |
ไม่เกิน 0.1 |
จับการขยับที่ตรวจพบในช่วงการทดสอบ |
| JavaScript ที่รับส่งเมื่อเปิดหน้า |
ไม่เกิน 250 KiB แบบบีบอัดในตัวอย่างนี้ |
ตรวจด้วยรายงานขนาดแยก โดยระบุ URL และ cache state |
ค่า LCP 3,500 ms ใน lab ตัวอย่างนี้เป็นเกณฑ์ของการทดสอบเฉพาะชุด ไม่ใช่การเปลี่ยนเกณฑ์ good ของ Core Web Vitals ที่ 2.5 วินาที และการผ่าน CLS ระหว่างโหลดหน้าก็ยังไม่ยืนยันว่าจะไม่มีการขยับหลังคนเลื่อนอ่านหรือเปิดส่วนอื่น
งบ 250 KiB ต้องระบุด้วยว่ารวมไฟล์อะไรบ้าง หากรายงานหนึ่งนับขนาดไฟล์ก่อนบีบอัด แต่อีกรายงานนับข้อมูลที่รับส่งจริง สองตัวเลขนั้นนำมาเทียบเป็น regression โดยตรงไม่ได้
เริ่มจากเพดานที่ทีมรักษาได้ แล้วกำหนดวันที่จะทบทวนเพื่อลดงบลง การตั้งเกณฑ์สูงจนทุกคนต้องขอยกเว้นทุกครั้งจะทำให้ gate เสียหน้าที่ตั้งแต่ต้น
อ่านค่าตั้งให้เห็นว่าระบบตัดสินอย่างไร
ด้านล่างเป็นตัวอย่าง lighthouserc.cjs สำหรับงานที่เตรียม static export ไว้แล้ว ค่าที่เข้มขึ้นทั้งหมดเป็นข้อเสนอ ควรตรึงเวอร์ชัน Lighthouse CI, Chrome และ dependencies ในการใช้งานจริง
module.exports = {
  ci: {
    collect: {
      staticDistDir: './out',
      url: [
        'http://localhost/th',
        'http://localhost/en',
      ],
      numberOfRuns: 3,
    },
    assert: {
      assertions: {
        'categories:performance': ['error', {
          minScore: 0.85,
          aggregationMethod: 'median',
        }],
        'largest-contentful-paint': ['error', {
          maxNumericValue: 3500,
          aggregationMethod: 'median',
        }],
        'total-blocking-time': ['error', {
          maxNumericValue: 300,
          aggregationMethod: 'median',
        }],
        'cumulative-layout-shift': ['error', {
          maxNumericValue: 0.1,
          aggregationMethod: 'median',
        }],
        'categories:accessibility': ['error', {
          minScore: 0.80,
          aggregationMethod: 'median',
        }],
      },
    },
    upload: {
      target: 'filesystem',
      outputDir: './lighthouse-results',
    },
  },
};
ตัวอย่างใช้ error ให้การผิดเกณฑ์จบด้วย exit code ที่ไม่เป็นศูนย์ และระบุ median ให้ใช้ค่ากลางของแต่ละตัวชี้วัดจาก 3 รอบอย่างชัดเจน อย่าอ่านค่าจาก run สุดท้ายใน manifest แล้วถือว่าเป็นผลตัดสินรวม เอกสารการตั้งค่า Lighthouse CI
งบ JavaScript ในตารางยังไม่ได้ถูกตรวจด้วยโค้ดชุดนี้ ต้องเพิ่มการตรวจขนาดที่ตกลงนิยามตรงกัน ส่วน Accessibility 0.80 เป็นเพียงค่าขั้นต่ำที่นำมาจาก workflow เดิม ไม่ใช่คำรับรองว่าเว็บไซต์เข้าถึงได้ตามมาตรฐานหรือใช้ keyboard และ screen reader ได้ครบทุกงาน
การตรึงเวอร์ชันช่วยให้รู้ว่าตัวเลขเปลี่ยนจากหน้าเว็บหรือเครื่องมือ เมื่อจะอัปเกรดเครื่องมือ ให้รัน baseline เก่าและใหม่เทียบกันก่อนปรับเกณฑ์ อย่าอัปเกรดและลดความเข้มของเกณฑ์ในงานเดียวจนแยกสาเหตุไม่ได้
ตัวอย่างเมื่อภาพใหม่ทำให้ release ติด gate
สมมติว่าหน้าบริการจะเปลี่ยนภาพหลักและเพิ่ม widget ภายนอก ตัวเลขทั้งหมดในส่วนนี้สร้างขึ้นเพื่ออธิบายการตัดสินใจ ไม่ใช่ผลของเว็บ Enersys
| ตัวชี้วัด |
baseline 3 รอบ |
candidate 3 รอบ |
ค่ากลางของ candidate |
| Performance |
0.88, 0.89, 0.87 |
0.87, 0.83, 0.84 |
0.84 |
| LCP |
2,800, 2,900, 2,850 ms |
3,700, 3,600, 3,900 ms |
3,700 ms |
| TBT |
140, 160, 150 ms |
170, 210, 190 ms |
190 ms |
candidate ไม่ผ่านตัวอย่างเกณฑ์ Performance และ LCP แม้รอบที่คะแนนดีที่สุดจะได้ 0.87 การเลือกภาพรายงานรอบนั้นมาแสดงอย่างเดียวทำให้คนอนุมัติเห็นข้อมูลไม่ครบ ส่วน TBT ยังอยู่ในงบ จึงไม่มีเหตุผลพอจะบอกว่า JavaScript เป็นสาเหตุหลักจากตารางนี้เพียงอย่างเดียว
ขั้นถัดไปคือเปิดรายงาน LCP และ network waterfall ดูว่า element ที่ถูกนับเป็นเนื้อหาหลักเปลี่ยนหรือไม่ ไฟล์ภาพใช้ขนาดเท่าไร browser เริ่มร้องขอเมื่อไร และ widget เข้ามาแย่งทรัพยากรช่วงใด ตั้งสมมติฐานแล้วเปลี่ยนทีละปัจจัย เช่น ทำภาพให้เหมาะกับขนาดที่แสดง จากนั้นวัดใหม่ด้วยเงื่อนไขเดิม
ในงานของนักพัฒนา ให้เริ่มจากจับคู่ LCP element กับ URL ของทรัพยากร แล้วแยกเวลารอ HTML เวลาก่อนเริ่มร้องขอทรัพยากร เวลาโหลด และเวลารอก่อนแสดงผล ถ้าร้องขอภาพช้า ให้ตรวจว่าหน้าเริ่มต้นเปิดเผยภาพให้ browser พบหรือยัง ถ้าไฟล์ใหญ่ ให้ปรับขนาดและการบีบอัด ถ้าโหลดเสร็จแล้วแต่ยังไม่แสดง ให้ตรวจงาน JavaScript หรือเงื่อนไขที่ซ่อนเนื้อหา แก้ส่วนที่รายงานชี้ วัดซ้ำ แล้วแนบ diff กับรายงานของ candidate ใหม่ วิธีแยกส่วนเวลาของ LCP
หากผลแก้ไขกลับเข้าเกณฑ์ ให้แนบรายงานใหม่เข้ากับ candidate ใหม่ด้วย ไม่ควรนำผลของไฟล์ชุดเก่ามาประกบโค้ดที่แก้ตามหลัง แม้แก้เพียงบรรทัดเดียว
ผลไม่ผ่านต้องแยกออกจากการตรวจที่ใช้ไม่ได้
เครื่องทดสอบที่แย่ง CPU กับงาน build อื่น อาจทำให้ผลแกว่ง ส่วน Chrome ที่เปิดไม่ได้หรือหน้าเว็บตอบ 404 ทำให้การตรวจใช้ยืนยันคุณภาพไม่ได้เลย ในข้อเสนอนี้ทั้งสองกรณีหยุดการปล่อยงานไว้ก่อน แต่ส่งต่อให้คนรับผิดชอบต่างกัน
เมื่อผิดเกณฑ์จริง เจ้าของการเปลี่ยนแปลงต้องตรวจ regression เมื่อเครื่องมือมีปัญหา ผู้ดูแลระบบทดสอบต้องคืนสภาพแวดล้อมให้พร้อม แล้วรัน candidate เดิมใหม่
นโยบาย retry ควรตกลงไว้ล่วงหน้า เช่น อนุญาตให้รันซ้ำ 1 ชุดเมื่อมีหลักฐานว่าเครื่องทดสอบผิดปกติ เก็บรายงานเดิมและเหตุผลไว้ด้วย หากผลชุดใหม่ยังแกว่งมาก ให้พักการตัดสินใจและแก้ความน่าเชื่อถือของการวัด การกดรันจนกว่าจะเจอสีเขียวทำให้เกณฑ์ที่ตั้งไว้ไม่มีความหมาย
ขั้นเก็บรายงานควรทำงานแม้ assertion ไม่ผ่าน และผลสุดท้ายยังต้องส่งสถานะไม่ผ่านกลับไป การเก็บ artifact สำเร็จไม่ได้แปลว่าการตรวจสำเร็จ เช่นเดียวกับงานที่ถูก skip หรือไม่มีรายงาน ไม่ควรถูกนับเป็น pass
จุดเชื่อมที่ทำให้รายงานกลายเป็นเงื่อนไขปล่อยงาน
ข้อเสนอของเราคือให้หลักฐานเดินไปกับ build ตั้งแต่สร้าง candidate จนขึ้น production
- ระบุ source commit, lockfile และเวอร์ชันเครื่องมือ แล้วสร้าง release candidate
- ให้ขั้นตรวจ performance อ่าน output ของ candidate นั้น ถ้า build เป็น container ให้ตรวจไฟล์ที่ดึงจาก image เดียวกัน หรือรัน image นั้นในสภาพแวดล้อมทดสอบ
- เก็บผลตรวจทุก URL พร้อม commit และ artifact หรือ image digest
- เปิดให้อนุมัติ production ต่อเมื่อผลตรวจที่ต้องใช้ครบและผ่าน แล้วปล่อย artifact เดิมตาม digest ที่ตรวจ
- ตรวจหน้าเว็บหลังปล่อยงาน และเชื่อมข้อมูลจากผู้ใช้จริงกลับมาที่ release
ใน GitHub Actions ถ้าออกแบบให้ขั้นตรวจและขั้น deploy อยู่ใน workflow เดียวกัน สามารถใช้ needs สร้างความสัมพันธ์ของงานได้ แต่รายละเอียดต้องรวมการส่งต่อ artifact และการตรวจตัวตนของ candidate ด้วย การตั้งชื่องานว่า Lighthouse เฉย ๆ ไม่ได้สร้างความสัมพันธ์นั้น ความสัมพันธ์ระหว่าง jobs ใน GitHub Actions
ถ้าปล่อยงานผ่านอีกระบบหนึ่ง เช่นเส้นทาง manual ที่มีอยู่ในปัจจุบัน ระบบนั้นต้องตรวจผลที่ผูกกับ digest เดียวกันก่อนอนุมัติด้วย มิฉะนั้นผลใน pull request จะเป็นเพียงข้อมูลประกอบที่ข้ามได้
ขั้นตอนเร่งด่วนควรมีช่องทางยกเว้นที่บันทึกชื่อผู้อนุมัติ เหตุผล ความเสี่ยง ระยะเวลายกเว้น และงานแก้ไขตามหลัง การยกเว้นต้องปรากฏใน release record ว่ายังไม่ผ่าน gate ตามปกติ จะได้ไม่กลายเป็นเรื่องเล่าว่า release นั้นผ่านทุกเงื่อนไข
เฝ้าต่อเมื่อ production เริ่มรับคนใช้
การตรวจ output ในเครื่องช่วยจับสิ่งที่เราส่งออกไป แต่ยังไม่ครอบคลุม DNS, CDN, cache, third-party service และอุปกรณ์ของคนใช้ ข้อเสนอจึงมีการตรวจ URL production หลังปล่อยงานเพื่อจับความต่างของสภาพแวดล้อมอีกชั้น
ระหว่าง release ควรตรวจตามกำหนดด้วย เพราะ third-party เปลี่ยนพฤติกรรมได้โดยไม่มี commit ของเรา กำหนดหน้าที่ตรวจ profile เวลา และเจ้าของการแจ้งเตือนให้คงที่พอจะเปรียบเทียบได้ ก่อนส่งเตือนควรแยกปัญหาหน้าล่มกับ regression ที่ต้องตรวจเพิ่ม
สำหรับ field data ให้ติดตาม p75 แยกตามประเภทหน้าและอุปกรณ์เท่าที่จำนวนตัวอย่างพอ ระบุช่วงเวลาของข้อมูลและวันที่ปล่อยงานไว้บนกราฟเดียวกัน ข้อมูลที่รวมหลาย release จะใช้สรุปผลของ release ล่าสุดทันทีไม่ได้
หากใช้ CrUX ต้องตรวจว่าข้อมูลเป็นระดับ URL หรือระดับ origin และมีข้อมูลพอหรือไม่ CrUX มีเงื่อนไขด้านผู้ใช้และความนิยมของหน้า การไม่พบข้อมูลจึงยังบอกไม่ได้ว่าเว็บเร็วหรือช้า วิธีเก็บข้อมูลของ CrUX
หากต้องเก็บข้อมูลเอง ให้เลือกเฉพาะ metric และบริบทที่ช่วยแก้ปัญหา เช่นกลุ่มหน้าและ release identifier พร้อมกำหนดวิธีจัดการข้อมูลให้เหมาะกับบริการ การเอาข้อความที่คนกรอกในฟอร์มมาติดกับเหตุการณ์ performance ไม่ได้ช่วยให้วัดความเร็วดีขึ้น
ให้ทีมเห็นหลักฐานก่อนคำรับรอง
คนที่อนุมัติ release ควรเปิดบันทึกแล้วตอบได้ว่า ตรวจหน้าไหน ตรวจ candidate ใด ใช้เกณฑ์เวอร์ชันอะไร มีผลไม่ผ่านหรือข้อยกเว้นอะไร และถ้าต้องย้อนกลับจะใช้ artifact ใด เจ้าของเนื้อหาควรรู้ว่าภาพหรือ embed ใหม่ใช้งบส่วนไหน เจ้าของระบบควรรู้ว่า alert แต่ละแบบส่งถึงใคร
ด้านธุรกิจ ความเร็วช่วยให้คนเข้าถึงเนื้อหาและทำงานต่อได้ แต่ตัวเลขที่เร็วขึ้นไม่ใช่หลักฐานว่ารายได้เพิ่มขึ้นเท่าไร หากต้องการเชื่อมกับการติดต่อหรือยอดขาย ต้องวัดผลนั้นต่างหาก Google ระบุเช่นกันว่าผล Core Web Vitals ที่ดีไม่ได้รับประกันอันดับสูงสุดในผลค้นหา คำอธิบายเรื่อง page experience ของ Google Search
สำหรับทีมที่เริ่มวันนี้ งานแรกที่คุ้มค่าคือเลือกหน้าสำคัญหนึ่งหน้า เก็บ baseline ที่ตรวจซ้ำได้ แล้วลองทำให้ candidate ผิดเกณฑ์โดยตั้งใจในสภาพแวดล้อมทดสอบ หากระบบยังเปิดให้ปล่อย candidate นั้นผ่านเส้นทางปกติได้ จุดที่ต้องแก้ก่อนคือการเชื่อมหลักฐานเข้ากับสิทธิ์ปล่อยงาน
ใน 30 วันแรก เราเสนอให้ระบุชื่อเจ้าของงานวิศวกรรมที่ดูแล baseline และทบทวน regression ทุกสัปดาห์ ผู้ดูแลระบบรับผิดชอบการตรวจตามกำหนดที่ขัดข้องและเหตุผิดปกติใน production ส่วนผู้อนุมัติ release บันทึกข้อยกเว้น เจ้าของเนื้อหาช่วยดูภาพและ embed ใหม่เทียบกับงบ เมื่อครบ 30 วัน ให้เจ้าของงานเหล่านี้ทบทวนผลไม่ผ่าน เหตุผลที่ retry เวลาตอบสนอง วันหมดอายุข้อยกเว้น และขอบเขต field data แล้วตัดสินว่าจะลดงบหรือแก้ช่องว่างการวัดก่อน ข้อนี้เป็นแผนแบ่งความรับผิดชอบที่เสนอ ยังไม่ใช่คำยืนยันว่า Enersys มอบหมายหน้าที่เหล่านี้แล้ว